MySQL 8.4 实战(一):InnoDB 与订单表结构设计
以可扩展订单系统为例,从业务不变量和访问模式出发,推导字段类型、业务约束、关联完整性、时间、金额与索引的表结构设计方法。
开始前请先完成准备篇并保存环境基线。
一张表能成功创建,不代表它适合长期承载业务。表结构设计真正需要回答的是:哪些事实必须由数据库保证,哪些约束属于业务流程,数据会以什么查询方式被读取,以及未来演进时哪些选择最难修改。
本文使用用户、订单、订单项和支付记录四张表,建立整个系列的公共模型。这个模型假设用户、订单和支付未来可能拆分服务或分库分表,核心数据不做物理级联删除,因此业务表保留关联列和查询索引,但不声明数据库外键。重点不是罗列 DDL,而是说明每个类型、约束和索引背后的业务不变量,以及取消物理外键后必须补上的完整性机制。
一、本文要解决的问题
- 金额、状态、业务编号、时间和可空字段应该如何表达?
- 主键、业务唯一键和检查约束分别保护什么?公共模型为什么不声明外键?
- 数据库约束与应用层校验如何分工?
- 为什么 DDL、savepoint 和事务边界必须单独验证?
二、实验索引
EX-M01-03 表示“实验(EX)—系列第一篇(M01)—本模块第 03 个实验”。本篇编号与正文一一对应:
| 实验 | 验证目标 | 正文位置 |
|---|---|---|
| EX-M01-03 | 创建四张公共表,核验引擎、索引、约束和外键策略 | §三 |
| EX-M01-04 | 生成分布固定的公共数据并核验基数 | §六 |
| EX-M01-05 | 观察约束错误、savepoint 和 DDL 隐式提交 | §七 |
EX-M01-01 和 EX-M01-02 的环境部署、参数基线、字符集与实验账号已移至准备篇。
三、EX-M01-03:创建并核验订单公共模型
公共案例包含四类事实:
用户:租户内邮箱唯一
订单:订单号唯一,属于一个用户,金额不能为负
订单项:同一订单中的 SKU 不重复,数量必须大于 0
支付:支付流水号唯一,可处于未支付、成功、失败或退款状态
先给出访问模式,再设计 DDL:
- 根据订单号查询订单详情;
- 根据用户查询最近订单;
- 根据租户和状态处理订单;
- 根据订单查询支付记录;
- 根据 SKU 追踪订单项。
这一步用于避免“先把所有字段建索引,再等待业务使用”的倒置设计。
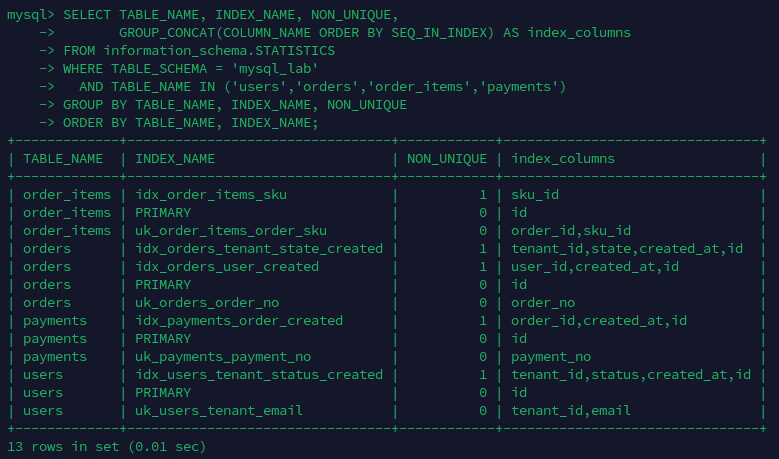
索引不是为了“看起来完整”:uk_* 承担业务唯一性,idx_orders_user_created 支持用户最近订单,idx_orders_tenant_state_created 支持租户内按状态扫描。
执行前先确认 mysql_lab 中没有同名业务表;如果表已经存在,不要为了重跑实验直接删除,应先确认其中是否有需要保留的数据。
完整建表 SQL
USE mysql_lab;


CREATE TABLE users (

  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,

  tenant_id INT UNSIGNED NOT NULL,

  email VARCHAR(200) NOT NULL,

  display_name VARCHAR(80) NOT NULL,

  status TINYINT UNSIGNED NOT NULL DEFAULT 1,

  created_at DATETIME(6) NOT NULL,

  updated_at DATETIME(6) NOT NULL,

  PRIMARY KEY (id),

  UNIQUE KEY uk_users_tenant_email (tenant_id,email),

  KEY idx_users_tenant_status_created (tenant_id,status,created_at,id)

) ENGINE=InnoDB;


CREATE TABLE orders (

  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,

  order_no VARCHAR(32) NOT NULL,

  tenant_id INT UNSIGNED NOT NULL,

  user_id BIGINT UNSIGNED NOT NULL,

  state TINYINT UNSIGNED NOT NULL

    COMMENT '订单状态:10=new,20=paid,30=shipped,40=cancelled',

  total_amount DECIMAL(12,2) NOT NULL,

  created_at DATETIME(6) NOT NULL,

  updated_at DATETIME(6) NOT NULL,

  PRIMARY KEY (id),

  UNIQUE KEY uk_orders_order_no (order_no),

  KEY idx_orders_user_created (user_id,created_at,id),

  KEY idx_orders_tenant_state_created (tenant_id,state,created_at,id),

  CONSTRAINT chk_orders_amount CHECK (total_amount >= 0)

) ENGINE=InnoDB;


CREATE TABLE order_items (

  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,

  order_id BIGINT UNSIGNED NOT NULL,

  sku_id BIGINT UNSIGNED NOT NULL,

  quantity INT UNSIGNED NOT NULL,

  unit_price DECIMAL(12,2) NOT NULL,

  created_at DATETIME(6) NOT NULL,

  PRIMARY KEY (id),

  UNIQUE KEY uk_order_items_order_sku (order_id,sku_id),

  KEY idx_order_items_sku (sku_id),

  CONSTRAINT chk_order_items_quantity CHECK (quantity > 0),

  CONSTRAINT chk_order_items_price CHECK (unit_price >= 0)

) ENGINE=InnoDB;


CREATE TABLE payments (

  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,

  payment_no VARCHAR(40) NOT NULL,

  order_id BIGINT UNSIGNED NOT NULL,

  channel VARCHAR(20) NOT NULL,

  state TINYINT UNSIGNED NOT NULL

    COMMENT '支付状态:10=pending,20=succeeded,30=failed,40=refunded',

  amount DECIMAL(12,2) NOT NULL,

  paid_at DATETIME(6) NULL,

  created_at DATETIME(6) NOT NULL,

  PRIMARY KEY (id),

  UNIQUE KEY uk_payments_payment_no (payment_no),

  KEY idx_payments_order_created (order_id,created_at,id),

  CONSTRAINT chk_payments_amount CHECK (amount >= 0)

) ENGINE=InnoDB;
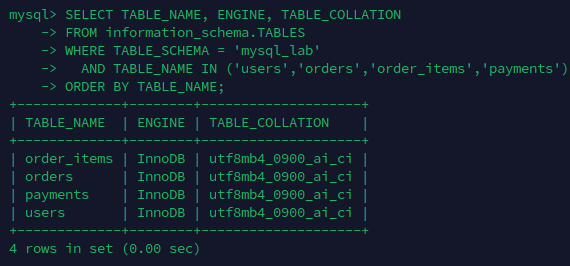
建表完成后,不只检查“命令没有报错”,还要从数据字典核验实际落地的对象:
SELECT TABLE_NAME, ENGINE, TABLE_COLLATION
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN ('users','orders','order_items','payments')
ORDER BY TABLE_NAME;
SELECT TABLE_NAME, INDEX_NAME, NON_UNIQUE,
       GROUP_CONCAT(COLUMN_NAME ORDER BY SEQ_IN_INDEX) AS index_columns
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN ('users','orders','order_items','payments')
GROUP BY TABLE_NAME, INDEX_NAME, NON_UNIQUE
ORDER BY TABLE_NAME, INDEX_NAME;
SELECT TABLE_NAME, CONSTRAINT_NAME, CONSTRAINT_TYPE
FROM information_schema.TABLE_CONSTRAINTS
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN ('users','orders','order_items','payments')
ORDER BY TABLE_NAME, CONSTRAINT_TYPE, CONSTRAINT_NAME;
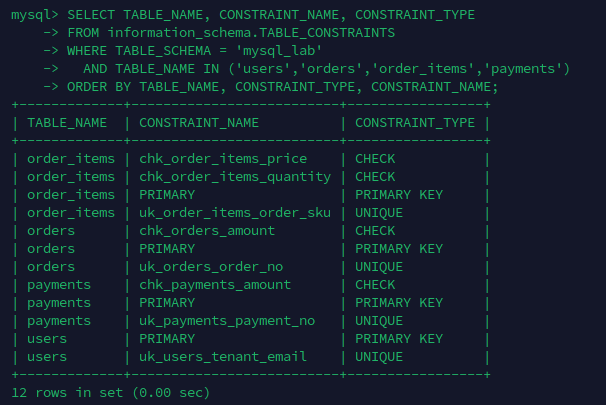
验收时逐项确认:四张表均使用 InnoDB 和预期排序规则;主键、业务唯一键及查询索引的列顺序与 DDL 一致;CHECK 约束出现在数据字典中,四张公共表没有 FOREIGN KEY。没有外键不等于没有关系:orders.user_id、order_items.order_id 和 payments.order_id 都有与访问模式匹配的显式索引,其中 uk_order_items_order_sku 的左前缀可支持按 order_id 访问。数据字典只能证明结构已经创建,约束与应用责任的行为边界还要在 EX-M01-05 中验证。
四、字段类型不是语法选择
4.1 金额
公共模型使用 DECIMAL(12,2)。12 是总有效位数,2 是小数位,因而非负业务值上界为 9,999,999,999.99。精度应来自币种最小单位、单笔上限和汇总需求,而不是复制某个模板。
DECIMAL 是精确值类型,FLOAT/DOUBLE 是近似值类型。金额的相等判断、税费舍入和对账需要统一的十进制规则,不应将二进制浮点误差引入持久化语义。另一种方案是用整数保存最小币种单位,但必须同时固定币种和 scale,不能只保存一个无单位的整数。
CHECK (amount >= 0) 仅表达本表金额的表示方式。如果退款采用负数流水,这项约束就不成立;本模型选择“金额恒为正,方向由交易类型表达”,避免一个符号同时承担数值与业务语义。
4.2 时间
公共模型区分:
created_at:记录创建时间;updated_at:最后修改时间;paid_at:支付业务事件时间,可以为空。
DATETIME(6) 保存日历值,不根据会话时区自动转换;TIMESTAMP(6) 在存储与读取时会在会话时区和 UTC 之间转换,且可表示范围更窄。对订单类长期数据,本文使用 DATETIME(6) 并约定应用统一写入 UTC;时区是协议的一部分,不是类型名自动解决的问题。
业务发生时间与数据库接收时间应按需并存。例如支付渠道回调中的 paid_at 可来自渠道,updated_at 则表示本系统完成状态修改的时间。只保存一个“时间”会让延迟、重放和对账无法区分。对核心记录,应用显式传值比依赖多个数据库默认值更容易测试和追踪。
4.3 状态与 NULL
订单和支付状态会随业务演进而扩展。公共模型使用 TINYINT UNSIGNED 保存状态码,在应用中分别定义订单枚举和支付枚举。整数表示紧凑,也适合订单表中包含 state 的联合索引;在类型容量内新增状态时,不必修改列定义。本文固定以下映射,后续实验沿用同一套编码:
| 状态码 | 订单状态 | 支付状态 |
|---|---|---|
| 10 | new:新建 |
pending:待支付 |
| 20 | paid:已支付 |
succeeded:支付成功 |
| 30 | shipped:已发货 |
failed:支付失败 |
| 40 | cancelled:已取消 |
refunded:已退款 |
状态码是持久化协议的一部分。应用枚举必须显式指定编码,不能把枚举的声明顺序直接存入数据库;已使用的编码不能更换含义或回收复用。订单与支付使用各自的状态集合,相同数字不表示相同业务含义。编码大小也不代表状态迁移顺序,不能用 state >= 20 之类的比较判断订单是否已支付。
TINYINT UNSIGNED 只限定整数范围,列注释只用于说明,两者都不会拒绝范围内但未定义的状态码。因此应用的写入入口需要统一校验合法取值,状态推进则通过事务内带前置状态的条件更新完成,并检查受影响行数。新增状态仍需协调应用发布:先让读取方能够识别新值或按约定处理未知值,再启用写入。公共模型不增加列举全部状态码的 CHECK,以免每次扩展状态都需要修改数据库约束,这也意味着绕过应用直接写库时,数据库无法兜底检查状态集合。
VARCHAR 保存稳定的业务代码也是合理方案,查询时更直观,但需要统一拼写与比较规则,并接受通常更大的索引占用。数据库 ENUM 更适合取值长期稳定、希望由数据库限定集合的字段;本文的订单模型选择把可演进的状态集合交给应用管理。无论采用哪种类型,合法状态之间能否转换都需要由业务状态机保证。
NULL 应只表示“未知或尚未发生”。paid_at IS NULL 因而可表示尚无成功支付时间,不能与空字符串或零时间混用。对参与唯一约束的可空列还要额外小心:MySQL 的唯一索引允许多个 NULL,所以不能用它直接表达“最多一个未知值”。
4.4 字符集和排序规则也是约束语义
utf8mb4 决定字符如何编码,collation 决定字符串如何比较和排序。公共库使用 utf8mb4_0900_ai_ci,其中 ai/ci 表示比较通常忽略重音和大小写。这不仅影响 ORDER BY,也影响唯一索引判断两个字符串是否相等。
例如租户邮箱唯一键 (tenant_id,email) 是否把大小写不同或带重音的值视为冲突,必须由业务规范化规则和实际 collation 共同决定。应用若先把邮箱转小写、数据库却使用另一套比较规则,仍可能在边界字符上出现不一致。作为 EX-M01-03 的补充观察,先记录实际会话配置和两个候选排序规则的属性:
SELECT @@character_set_server, @@collation_server,
       @@character_set_connection, @@collation_connection;

SELECT COLLATION_NAME, CHARACTER_SET_NAME, PAD_ATTRIBUTE
FROM information_schema.COLLATIONS
WHERE COLLATION_NAME IN ('utf8mb4_0900_ai_ci','utf8mb4_0900_as_cs');

SELECT
  _utf8mb4'A' COLLATE utf8mb4_0900_ai_ci =
    _utf8mb4'a' COLLATE utf8mb4_0900_ai_ci AS case_equal,
  _utf8mb4'e' COLLATE utf8mb4_0900_ai_ci =
    _utf8mb4'é' COLLATE utf8mb4_0900_ai_ci AS accent_equal,
  _utf8mb4'a' COLLATE utf8mb4_0900_ai_ci =
    _utf8mb4'a ' COLLATE utf8mb4_0900_ai_ci AS trailing_space_equal;
记录三个比较表达式的返回值,并结合 PAD_ATTRIBUTE 解释差异。这里的目的不是预设所有排序规则都给出同一结果,而是避免把其他版本或其他 collation 的现象直接套到当前表上。等值比较还不能代替唯一键实验;真正写入时是否冲突,应以 EX-M01-05 返回的约束错误为准。
VARCHAR(200) 中的 200 是字符上限,不是固定 200 字节。多字节字符会影响实际行宽、临时结果和索引大小;设计宽字符串索引时要结合字符集、字段长度、页大小和实际数据验证,而不是只比较字符数。
连接还有 character_set_client、character_set_connection 和 character_set_results。客户端字节若以错误字符集解释,数据在进入表之前就可能被错误转换。生产连接池应显式、统一配置连接字符集,并通过实际会话变量确认,而不是只看建库默认值。
五、数据库约束与关联完整性
5.1 技术主键与业务唯一键
递增 BIGINT UNSIGNED 只承担单实例行标识;order_no 和 payment_no 承担幂等与业务查找。下一篇文章会进一步比较分布式 ID 和随机二进制 ID。
5.2 数据库约束保护的边界
| 约束 | 本例保护内容 | 仍需应用保证 |
|---|---|---|
| 主键 | 行标识不重复 | ID 生成策略与业务语义 |
| 唯一键 | 订单号、支付号、租户邮箱不重复 | 冲突后的幂等响应 |
| CHECK | 数量和金额的基础范围 | 状态转换与跨行总额一致性 |
| 外键 | 公共模型未使用;独立实验表用于观察引用完整性 | 生产关联由应用事务、生命周期策略、对账和补偿保证 |
5.3 外键的成本、局限与本文取舍
外键的直接收益是由数据库统一维护引用完整性:无论写入来自业务服务、脚本还是人工 SQL,数据库都会拒绝不满足关联约束的数据。这种保护也有写入成本,并会影响复制回放和业务演进,需要结合订单系统的访问模式与部署边界评估。
首先是写入时的检查与加锁。插入订单或修改 user_id 时,如果存在外键,InnoDB 需要通过关联索引检查用户记录;删除被引用的用户或修改其引用键时,也需要检查关联订单。外键检查会对需要检查的父表或子表记录加共享行锁,因此一次业务写入可能涉及更多索引访问和记录锁。共享锁之间可以兼容,但与冲突的更新、删除并发时,可能增加锁等待和死锁机会。实际开销取决于缓存命中、关联规模、事务长度和热点竞争,不能直接推导出固定比例的吞吐下降。检查与锁行为见官方说明。
其次是副本的并行回放能力。这里讨论的是副本应用源库事务的并行度。MySQL 8.4 使用写集生成事务依赖信息,帮助副本识别可以并行应用的事务;对于被标记为存在相关外键依赖的事务,实现会放弃本次写集依赖优化,沿用较保守的提交顺序依赖,并清空写集历史。因此,外键相关写入可能减少副本可利用的并行机会,影响回放吞吐和追赶能力,但不意味着整个副本只能单线程执行。是否形成瓶颈仍需结合事务分布、worker 状态和复制延迟观察。版本行为见 MySQL 8.4 说明,依赖处理见 MySQL 8.4.0 源码。
业务与运维上的限制同样需要提前考虑。用户注销后,订单可能仍需保留;订单归档时,明细和支付也可能采用不同保留策略。外键要求这些操作遵守引用关系,使用 RESTRICT 需要先处理关联记录,使用 CASCADE 则可能扩大一次删除或更新的范围。未来拆到不同 MySQL 实例时,原有外键无法继续跨实例维护关联;在 MySQL 8.4 中,InnoDB 用户定义分区表也不能作为外键的父表或子表。此外,外键关系会使部分元数据锁延伸到关联表,增加结构变更时需要协调的对象。限制与锁范围见官方说明。
结合这些成本与限制,本文公共模型采用以下业务前提:
- 用户、订单和支付具有不同生命周期,未来允许拆分服务和存储;
- 订单量增长后需要评估分片、归档或 MySQL 原生分区;
- 核心订单和支付记录不物理级联删除,用户注销通过状态、匿名化和保留策略处理;
- 发布、批量导入、恢复和在线结构变更不能依赖复杂的跨表执行顺序。
综合写入路径的检查与锁成本、副本并行回放的限制,以及拆分、归档和结构变更的需求,四张公共表不声明物理外键。user_id 和 order_id 保留逻辑关联及必要的查询索引,由业务层维护引用完整性。即使 order_items 当前与订单同属一个聚合,公共模型仍统一采用无外键策略,以便后续分区、分片和恢复实验复用同一套 DDL。这是本文架构前提下的选择,不是已经通过压测证明的性能结论。
外键仍有适用场景:数据长期同库、同事务、同生命周期,并且所有写入口都需要数据库强制拒绝孤儿记录时,外键通常比应用约定更可靠。为了掌握这一机制,EX-M01-05 使用独立的 fk_lab_parent 和 fk_lab_child 实验,不让教学用约束进入后续公共模型。
5.4 无外键后的工程契约
采用逻辑关联后,完整性维护的责任和成本转移到了应用。单独执行“先查询父记录,再插入子记录”仍有并发竞态,需要配合同库事务、受控删除和生命周期管理;跨服务流程还需要幂等、对账与补偿。公共模型至少要把以下规则落实到应用和运行手册:
| 场景 | 写入契约 | 失败后的发现与修复 |
|---|---|---|
| 创建订单 | 校验用户状态;同库时在明确事务边界内写入,跨服务时保存用户标识和必要快照 | 幂等订单号吸收重试,用户/租户关联定期对账 |
| 写入订单项 | 订单与明细作为同一聚合提交;不允许明细脱离订单单独创建 | 扫描孤儿明细,告警后按业务记录补偿或隔离 |
| 支付回调 | payment_no 去重,条件更新合法状态,事务内记录 outbox |
重试、补偿并核对支付渠道账单 |
| 用户注销 | 禁止直接级联删除历史订单;使用禁用、匿名化和保留策略 | 审计物理删除权限及异常删除事件 |
此外,应定期扫描不存在用户的订单、不存在订单的明细和支付记录,并告警、修复;备份恢复后也要重新执行关联完整性校验。对账能够发现遗漏,但不能提供外键那样在写入时同步拒绝非法引用的保证。
六、EX-M01-04:生成并核验公共数据
这个实验生成 1 万个用户,并由用户 id 一一派生订单、订单项和支付记录。固定的取模规则使每次从空表重建后都得到相同的租户、状态、时间和 SKU 分布,后续专题才能进行单变量对照。
执行前先确认四张表都为空。以下 SQL 不是幂等脚本,直接重复执行会被业务唯一键拒绝;需要重建时,应回到 EX-M01-03,从确认过的空实验库重新开始。
完整造数 SQL
USE mysql_lab;

SET SESSION cte_max_recursion_depth = 20000;


INSERT INTO users

  (tenant_id,email,display_name,status,created_at,updated_at)

WITH RECURSIVE seq AS (

  SELECT 1 AS n

  UNION ALL SELECT n + 1 FROM seq WHERE n < 10000

)

SELECT 1 + MOD(n,10),

       CONCAT('user',n,'@example.test'),

       CONCAT('user-',n),

       IF(MOD(n,20)=0,0,1),

       TIMESTAMP('2024-01-01') + INTERVAL MOD(n,730) DAY,

       TIMESTAMP('2024-01-01') + INTERVAL MOD(n,730) DAY

FROM seq;


INSERT INTO orders

  (order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)

SELECT CONCAT('ORD',LPAD(id,20,'0')),

       tenant_id,

       id,

       10 * (1 + MOD(id,4)), -- 10=new,20=paid,30=shipped,40=cancelled

       CAST(10 + MOD(id*37,100000)/100 AS DECIMAL(12,2)),

       created_at + INTERVAL MOD(id,60) MINUTE,

       created_at + INTERVAL MOD(id,60) MINUTE

FROM users;


INSERT INTO order_items

  (order_id,sku_id,quantity,unit_price,created_at)

SELECT id,

       100000 + MOD(id,1000),

       1 + MOD(id,5),

       CAST(total_amount/(1+MOD(id,5)) AS DECIMAL(12,2)),

       created_at

FROM orders;


INSERT INTO payments

  (payment_no,order_id,channel,state,amount,paid_at,created_at)

SELECT CONCAT('PAY',LPAD(id,20,'0')),

       id,

       ELT(1+MOD(id,3),'card','wallet','bank'),

       IF(state IN (20,30),20,10), -- 已支付或已发货订单派生成功支付,其余为待支付

       total_amount,

       IF(state IN (20,30),created_at + INTERVAL 2 MINUTE,NULL),

       created_at + INTERVAL 1 MINUTE

FROM orders;
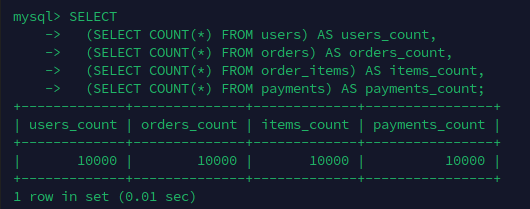
造数完成后同时核验总量和人工分布:
SELECT
  (SELECT COUNT(*) FROM users) AS users_count,
  (SELECT COUNT(*) FROM orders) AS orders_count,
  (SELECT COUNT(*) FROM order_items) AS items_count,
  (SELECT COUNT(*) FROM payments) AS payments_count;
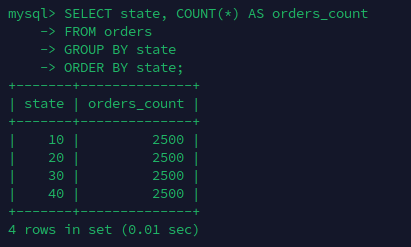
SELECT state, COUNT(*) AS orders_count
FROM orders
GROUP BY state
ORDER BY state;
SELECT state, COUNT(*) AS payments_count,
       SUM(paid_at IS NULL) AS paid_at_null_count
FROM payments
GROUP BY state
ORDER BY state;
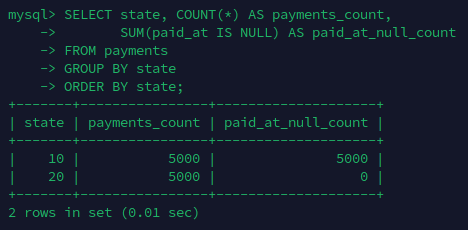
验收条件是四张表均为 10,000 行,订单状态 10/20/30/40 各占 2,500 行;支付状态 10(待支付)和 20(成功)各占 5,000 行,对应的 paid_at_null_count 分别为 5,000 和 0。本批数据不生成失败或退款支付。任一结果不符时都应先检查数据是否从空表生成、递归上限是否生效以及前序语句是否报错,再继续后续实验。
这批数据的目标是可复现,不是模拟生产流量:它没有长尾用户、节假日峰值、热门 SKU 或状态相关性。任何基数、优化器和性能结论都必须把人工分布写进边界。
七、EX-M01-05:验证约束、savepoint 与 DDL 隐式提交
失败语句也是证据。这个实验依次观察数据库约束如何拒绝非法行、语句失败后事务是否仍然存在,以及 DDL 如何改变事务边界。每条预期失败的语句都应单独执行并记录完整错误码;不要把注释中的预期现象当作实际结果。
7.1 数据库约束与逻辑关联的边界
先观察公共表的 CHECK 会拒绝非法金额,而无外键的逻辑引用需要由应用负责。第二笔探针写入放在事务中并回滚,不污染公共数据:
-- 观察 chk_orders_amount 是否拒绝负金额。
INSERT INTO orders
  (order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
VALUES
  ('CHECK-PROBE',1,1,10,-0.01,NOW(6),NOW(6));
验收时记录负金额写入的错误码和约束名;
7.2 唯一键冲突与 savepoint
下面故意在同一租户内写入仅大小写不同的邮箱,同时观察唯一键的 collation 语义和语句失败后的事务状态。开始前确认租户 1 中没有 case.probe@example.test 这条实验记录。以下步骤在同一连接中按顺序执行,第二次 INSERT 的唯一键冲突是预期结果,记录后继续执行回到 savepoint 和提交的语句:
START TRANSACTION;

INSERT INTO users
  (tenant_id,email,display_name,status,created_at,updated_at)
VALUES
  (1,'Case.Probe@example.test','first',1,NOW(6),NOW(6));

SAVEPOINT before_duplicate;

-- 预期报 ERROR 1062,约束名为 uk_users_tenant_email;单独执行并记录错误。
INSERT INTO users
  (tenant_id,email,display_name,status,created_at,updated_at)
VALUES
  (1,'case.probe@example.test','second',1,NOW(6),NOW(6));

-- 预期成功:确认唯一键冲突后,原事务的 savepoint 仍可使用。
ROLLBACK TO SAVEPOINT before_duplicate;
COMMIT;

SELECT COUNT(*) AS committed_rows
FROM users
WHERE tenant_id = 1
  AND email = 'case.probe@example.test';

SELECT email, display_name
FROM users
WHERE tenant_id = 1
  AND email = 'case.probe@example.test';
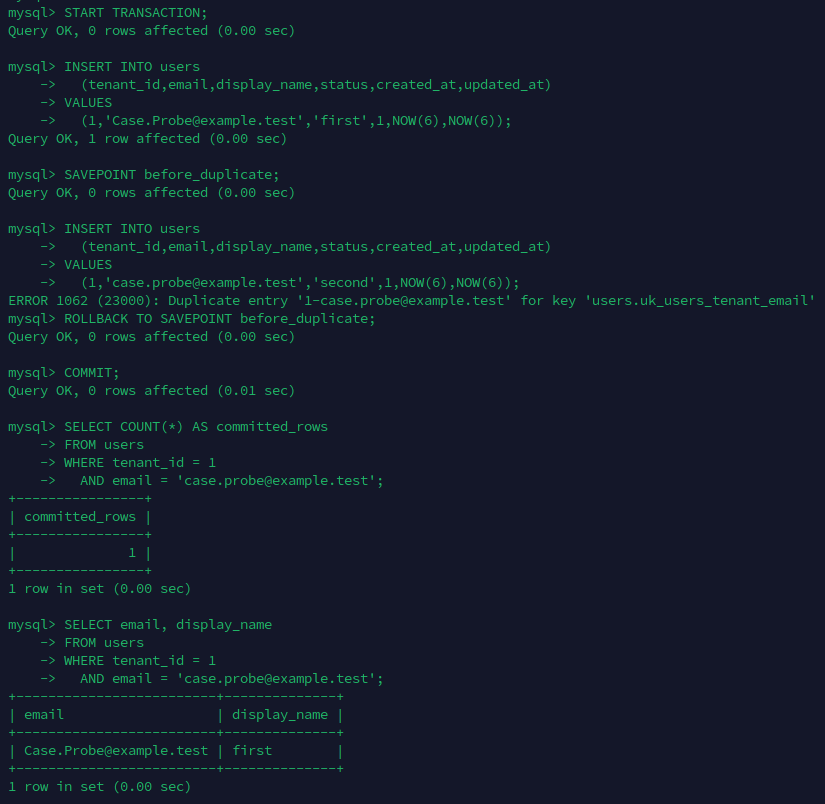
验收时确认:第二次 INSERT 报 1062;ROLLBACK TO SAVEPOINT 成功;提交后 committed_rows=1,保留的记录为 Case.Probe@example.test,display_name 为 first。第一条记录写在 savepoint 之前,因此回到该位置不会撤销它。原 savepoint 仍然可用,说明这次唯一键冲突没有使整个事务结束;如果出现 1305(savepoint 不存在)或其他非预期错误,应先排查连接是否变化、事务是否已经结束及前序语句是否成功。
本例的 InnoDB 唯一键冲突只回滚失败的语句,但不能把它推广为所有错误都会保留事务,例如死锁可能导致整个事务回滚。实验直接通过 savepoint 和提交后的数据验证行为;
7.3 DDL 隐式提交
先确认 users.id=1 来自 EX-M01-04,原始 display_name 为 user-1,并已完成上一节的提交。实验使用独立的普通探针表,观察执行 DDL 后,ROLLBACK 是否还能撤销之前的数据修改:
DROP TABLE IF EXISTS ddl_commit_probe;

SELECT id, display_name FROM users WHERE id = 1;

SET autocommit = 0;
UPDATE users SET display_name = 'before-ddl' WHERE id = 1;

-- 普通 CREATE TABLE 会隐式提交之前的 UPDATE。
CREATE TABLE ddl_commit_probe (
  id INT NOT NULL PRIMARY KEY
) ENGINE=InnoDB;

ROLLBACK;

SELECT id, display_name FROM users WHERE id = 1;
SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'ddl_commit_probe';
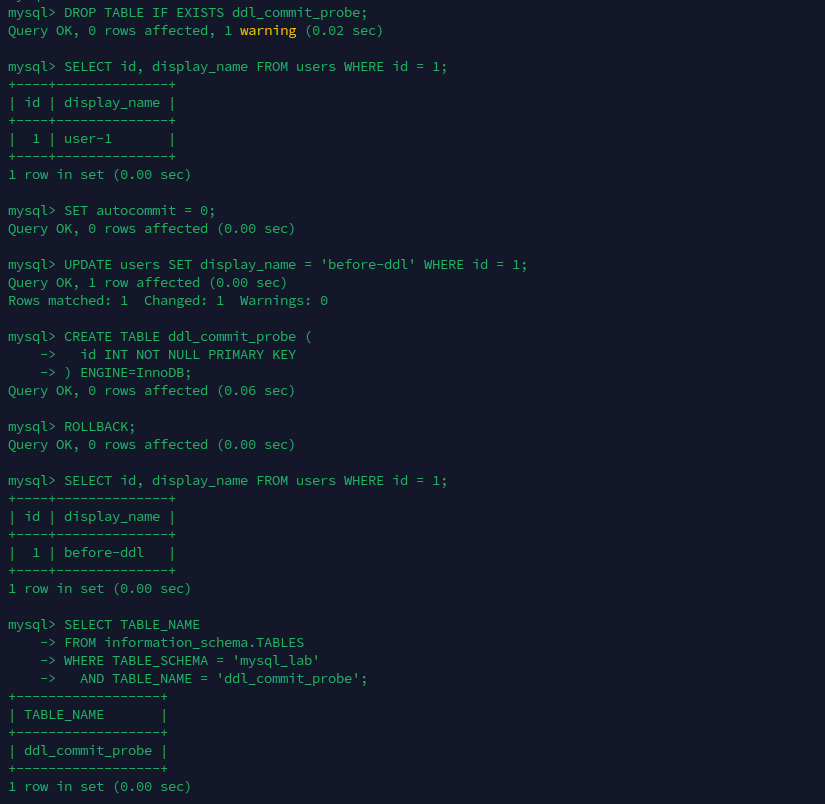
验收时确认:执行 ROLLBACK 后,users.id=1 的名称仍为 before-ddl,数据字典仍返回 ddl_commit_probe。普通 CREATE TABLE 在执行前隐式提交了此前的 UPDATE,因此后续回滚无法恢复原名称,已创建的普通表也不会被撤销。不要将探针改为 TEMPORARY 表,其事务行为不同。SET autocommit=0 也不能阻止这类隐式提交,所以应通过实际数据结果识别事务边界,而不能只看回滚命令是否成功返回。
实验结束后恢复公共数据:
DROP TABLE IF EXISTS ddl_commit_probe;
SET autocommit = 1;

UPDATE users SET display_name = 'user-1' WHERE id = 1;
DELETE FROM users
WHERE tenant_id = 1
  AND email = 'case.probe@example.test';

SELECT
  (SELECT COUNT(*) FROM users) AS users_count,
  (SELECT COUNT(*) FROM orders) AS orders_count,
  (SELECT COUNT(*) FROM order_items) AS items_count,
  (SELECT COUNT(*) FROM payments) AS payments_count;
清理后的验收条件是 DDL/外键探针表均不存在、users.id=1 恢复为 user-1,并且四张公共表仍各有 10,000 行,供后续专题继续使用。
八、阶段性结论
- DOCUMENTED:
DECIMAL保存精确定点值;TIMESTAMP受会话时区转换影响;字符集决定编码,排序规则参与比较、排序和唯一性判断;InnoDB 支持主键、唯一键、CHECK和外键,DDL 中有多类语句会造成隐式提交。 - INFERRED:在本文声明的可扩展订单平台边界下,业务公共表不使用物理外键;行内不变量和业务唯一性仍交给数据库,逻辑引用、状态迁移、跨行总额和跨服务流程则由应用事务、幂等、生命周期控制、补偿与持续对账共同保证。
本篇最重要的方法是:先写业务不变式和访问模式,再决定类型、约束和索引。后续主键、分区与分片的选择都会回到这些语义,而不是从 DDL 语法开始。
参考资料
- MySQL 8.4 Reference Manual:InnoDB
- MySQL 8.4 Reference Manual:Data Types
- MySQL 8.4 Reference Manual:CREATE TABLE
- MySQL 8.4 Reference Manual:Using Foreign Key Constraints
- MySQL 8.4 Reference Manual:FOREIGN KEY Constraint Differences
- MySQL 8.4 Reference Manual:What Is New in MySQL 8.4 since MySQL 8.0
- MySQL 8.4.0 Source:Transaction Dependency Tracking
- MySQL 8.4 Reference Manual:Fixed-Point Types
- MySQL 8.4 Reference Manual:Statements That Cause an Implicit Commit
- MySQL 8.4 Reference Manual:SAVEPOINT, ROLLBACK TO SAVEPOINT, and RELEASE SAVEPOINT Statements
- MySQL 8.4 Reference Manual:InnoDB Error Handling
- MySQL 8.4 Reference Manual:Character Sets and Collations