MySQL 8.4 实战(三):EXPLAIN ANALYZE 与查询优化器
建立从查询目标、统计信息、估算行数到实际迭代器的执行计划分析方法,用证据判断全表扫描、回表、排序和索引提示。
慢查询分析最容易犯的错误,是看到 ALL 就立即加索引,或看到 Using filesort 就假设发生了磁盘排序。执行计划不是标签检查表,而是优化器根据 SQL、索引、统计信息和成本模型构造的执行路径。
一、本文要解决的问题
EXPLAIN估算和EXPLAIN ANALYZE实测分别回答什么?- 如何阅读 TREE 格式中的迭代器、行数、循环和时间?
- 如何识别错误估算、无效访问路径和高成本排序?
- 统计信息、直方图和索引提示应该在什么情况下使用?
- 如何避免缓存和数据规模让实验结论失真?
二、证据地图
| 实验 | 对照内容 | 状态 |
|---|---|---|
| EX-M03-01 | estimated rows 与 actual rows | PASSED |
| EX-M03-02 | 连接、聚合、循环和排序 | PASSED |
| EX-M03-03 | 删除/恢复索引前后的计划 | PASSED |
| EX-M03-04 | ANALYZE 与 histogram 前后估算 | PASSED |
| EX-M03-05 | 普通计划与 FORCE INDEX | NOT_STARTED |
三、先区分解释与执行
3.1 普通 EXPLAIN
普通 EXPLAIN 用于查看优化器选择的路径和估算,不执行 SELECT 主体。优化器使用表/索引统计、列选择性和成本模型构造候选路径,再选择估算成本较低的一个。它回答的是“MySQL 准备怎样执行”,不是“这次执行实际花了多少工作”。
需要关注:
- 访问对象与顺序;
- 使用的索引;
- 访问类型;
- 估算行数和过滤比例;
- 排序、临时结果与附加条件。
TRADITIONAL 格式的 type=ALL、key、rows、filtered 适合快速扫描,TREE 格式更适合表达迭代器父子关系,JSON 格式便于程序化分析。“Using filesort”只表示不能直接按所选索引顺序产生最终顺序,不能仅凭这个标签断定已经落盘排序。
3.2 EXPLAIN ANALYZE
它会实际执行语句,并用 TREE 展示迭代器的估算和实测。对更新或删除语句使用前必须确认副作用;本系列只对可安全执行的查询使用。
一个节点的形式可简化为:
Index range scan ... (cost=... rows=estimated)
  (actual time=first..all rows=actual loops=N)
first 是该迭代器每轮返回首行的平均时间,all 是每轮完成的平均时间,rows 是每轮平均返回行,loops 是迭代器被调用的次数。多轮时不能把显示的 actual time 直接当成累计总时间;判断被驱动节点的总工作量,至少要同时看每轮行数和 loops。父节点时间包含子迭代器工作,因此也不能把整棵树的节点时间简单相加。
四、EX-M03-01:从一条订单查询开始
继续第二篇的订单列表查询:租户 2 的已支付订单(state=20),按时间和 ID 倒序取 20 条。第一篇的公共基线在此条件下有 500 笔订单,执行前先确认已完成第二篇的副本清理。
SELECT *
FROM orders
WHERE tenant_id=2 AND state=20
ORDER BY created_at DESC,id DESC
LIMIT 20;
执行前分析:
(tenant_id,state,created_at,id)是否能连续定位?- 索引顺序能否避免额外排序?
SELECT *是否需要回表?LIMIT 20在计划中的停止位置在哪里?
候选索引 (tenant_id,state,created_at,id) 的前两列都是等值,所以可以定位到一个租户、一种状态的连续区间,再按 created_at 反向读取。但 SELECT * 包含不在该索引中的列,因此返回的候选记录需要回聚簇索引取完整行。LIMIT 20 只有在前面不需要先消耗全部候选做排序/聚合时,才能让读取提前停止。
本次同时保存预测计划和实际迭代器输出:
EXPLAIN FORMAT=TREE
SELECT * FROM orders
WHERE tenant_id=2 AND state=20
ORDER BY created_at DESC,id DESC LIMIT 20;

EXPLAIN ANALYZE
SELECT * FROM orders
WHERE tenant_id=2 AND state=20
ORDER BY created_at DESC,id DESC LIMIT 20;
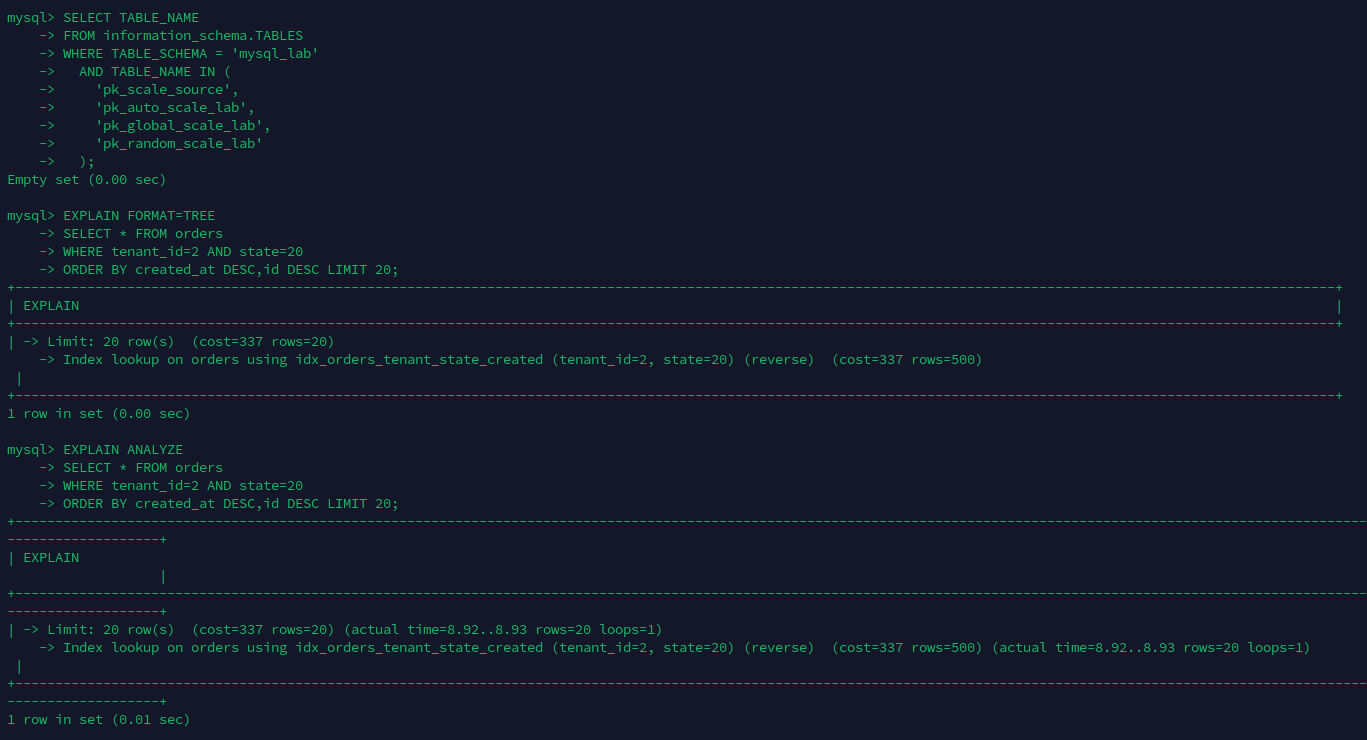
| 指标 | EXPLAIN 估算 | ANALYZE 实际 | 差异原因或口径说明 |
|---|---|---|---|
Limit 输出行数 |
20 | 20 | 估算与实际一致,达到 20 行后停止向下层取数 |
| 索引迭代器返回行数 | 500 | 20 | 500 是完整索引范围的估算基数;实际只被 Limit 消费 20 行,不是普通的估算偏差 |
| 循环次数 | — | 1 | 查询没有外层循环驱动,该索引迭代器只初始化一次 |
| 优化器成本 | 337 | — | cost 是优化器内部成本值,不是毫秒,不能与实际时间比较 |
| 首行时间 | — | 8.92 ms | 实际执行后才有,包括初始化、定位索引起点并取得首行的时间 |
| 迭代器完成时间 | — | 8.93 ms | 取得第 20 行即被 Limit 提前终止,没有读取其余匹配行 |
这里最容易误读的是 rows=500 与 rows=20。下层 Index lookup 根据 tenant_id=2 AND state=20 估算完整范围有 500 行;上层 Limit 只需要 20 行,因此实际执行时在收到第 20 行后就不再调用下层迭代器。于是索引节点显示 actual rows=20,它表达的是实际向父节点返回了多少行,而不是证明完整范围实际只有 20 行。公共基线中该条件确实匹配 500 行;若要单独验证这项基数估算,应使用 COUNT(*) 或移除 LIMIT 后再执行 EXPLAIN ANALYZE。
actual time=8.92..8.93 的单位是毫秒:前一个值是该迭代器返回首行的时间,后一个值是完成本次迭代的时间。两者只差约 0.01 ms,说明主要时间发生在初始化和取得首行之前;索引已经提供 created_at DESC,id DESC 所需顺序,随后反向读取到第 20 行即可停止,不需要先扫描 500 行再排序。由于查询使用 SELECT *,二级索引并不覆盖全部投影列,实际返回的 20 行仍需读取聚簇记录。
计划中的两个节点都显示接近 8.93 ms,是因为 Limit 的时间包含下层索引迭代器完成的工作,父子节点时间不能相加。单次结果也无法证明 8.92 ms 全部来自磁盘 I/O 或缓存未命中;要分析缓存影响,需要在相同条件下重复执行并比较首轮与后续轮次。
五、EX-M03-02:连接计划必须看 loops
本次使用用户与订单聚合查询观察多个迭代器:
EXPLAIN ANALYZE
SELECT u.id,COUNT(o.id) AS order_count,SUM(o.total_amount) AS amount
FROM users AS u
LEFT JOIN orders AS o ON o.user_id=u.id
WHERE u.tenant_id=3
GROUP BY u.id
ORDER BY amount DESC
LIMIT 20;
需要回答:
- 哪张表是驱动输入;
- 被驱动索引查找执行了多少次;
- 聚合和排序发生在哪一层;
LEFT JOIN如何影响结果与优化空间;- 父节点时间为什么不能与子节点时间简单相加。
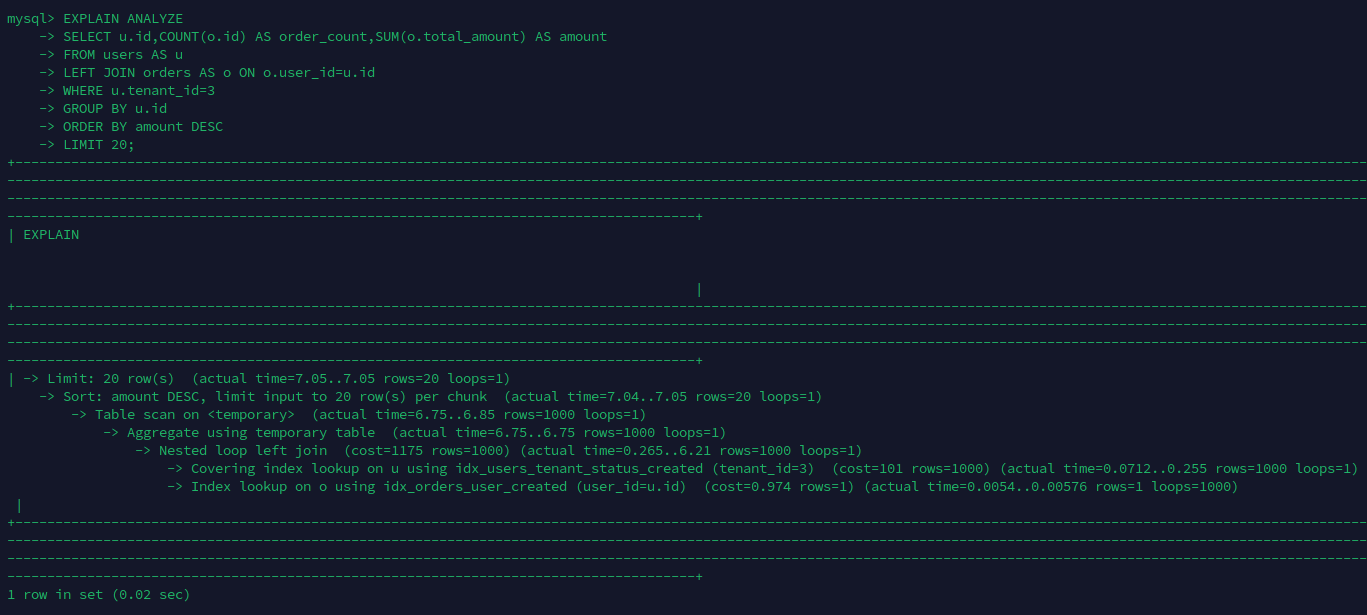
5.1 第一步:从叶子节点确定驱动输入
执行树要从最深层向上读。最先执行的是:
Covering index lookup on u using idx_users_tenant_status_created
  (tenant_id=3) (cost=101 rows=1000)
  (actual time=0.0712..0.255 rows=1000 loops=1)
users 是驱动表。tenant_id=3 使用联合索引的最左列定位,估算和实际都返回 1,000 个用户,且只执行一次。查询在用户侧只需要 u.id,该值已经包含在索引中,所以这里是覆盖索引访问,不需要读取 users 的聚簇记录。
5.2 第二步:用 rows 和 loops 还原内层总工作量
每取得一个用户,Nested-loop 都会执行一次订单索引查找:
Index lookup on o using idx_orders_user_created (user_id=u.id)
  (cost=0.974 rows=1)
  (actual time=0.0054..0.00576 rows=1 loops=1000)
这里的 rows=1 和 actual time=0.0054..0.00576 都是每轮平均值,不能把 0.00576 ms 当作全部订单查找的耗时。内层迭代器执行了 1,000 次,因此可以近似还原:
订单查找次数       = loops = 1000
订单返回总行数     ≈ rows × loops = 1 × 1000 = 1000
订单查找累计时间   ≈ 0.00576 ms × 1000 = 5.76 ms
这个乘法用于理解量级,受计时精度和平均值取整影响,不应当作精确的节点独占时间。idx_orders_user_created 可以根据 user_id 定位订单,但 SUM() 还需要索引中没有的 total_amount,所以订单侧不是覆盖索引访问,匹配后仍需读取聚簇记录。
5.3 第三步:沿执行树向上观察连接、聚合和排序
各节点的估算和实际工作量如下:
| 顺序 | 迭代器 | 估算行 | 实际行 | loops |
actual time(ms) |
解读 |
|---|---|---|---|---|---|---|
| 1 | users 覆盖索引查找 |
1000 | 1000 | 1 | 0.0712..0.255 | 取得租户 3 的全部用户 |
| 2 | orders 索引查找 |
1 | 1 | 1000 | 0.0054..0.00576 | 每个用户执行一次,行数和时间均为每轮平均值 |
| 3 | Nested-loop left join | 1000 | 1000 | 1 | 0.265..6.21 | 合并 1,000 次内层查找的结果 |
| 4 | 使用临时表聚合 | — | 1000 | 1 | 6.75..6.75 | 按 u.id 生成 1,000 个分组 |
| 5 | 扫描临时表 | — | 1000 | 1 | 6.75..6.85 | 把全部分组交给排序节点 |
| 6 | 按 amount DESC 排序 |
— | 20 | 1 | 7.04..7.05 | 消费 1,000 个分组,只保留并输出前 20 个 |
| 7 | Limit 20 |
— | 20 | 1 | 7.05..7.05 | 返回最终结果 |
Nested-loop 输出 1,000 行后,GROUP BY u.id 使用内部临时表生成 1,000 个聚合结果。聚合节点的首行时间和完成时间同为 6.75 ms,反映出它必须先消费连接结果并完成临时表聚合,之后上层才能扫描聚合结果。
amount 是运行时计算出的 SUM(o.total_amount),基础表索引不能直接提供它的倒序,因此必须在聚合后排序。计划中的 limit input to 20 row(s) per chunk 表示排序过程利用了 LIMIT 20 控制候选结果规模,但仍需查看全部 1,000 个分组才能确定金额最大的 20 个。这里的 LIMIT 只能减少最终输出,不能让底层用户扫描、1,000 次订单查找或聚合提前停止。
5.4 第四步:检查语义、估算偏差和主要成本
当前公共数据是一名用户对应一笔订单,因此用户查找的 1,000 行、订单侧每轮 1 行和连接输出的 1,000 行都与估算一致,没有明显的基数估算偏差。主要成本不是最后返回的 20 行,而是订单索引查找被执行了 1,000 次;其累计时间约 5.76 ms,也与 Nested-loop 在约 6.21 ms 完成相吻合。
这条 SQL 使用 LEFT JOIN,语义上要保留没有订单的用户:此时 COUNT(o.id) 为 0,SUM(o.total_amount) 为 NULL。当前数据中每个用户恰好都有订单,只能说明本次结果与内连接碰巧相同,不能据此把业务 SQL 改写为 INNER JOIN;如果业务要求无订单用户的金额显示为 0,应显式使用 COALESCE(SUM(o.total_amount),0)。
根节点、排序、临时表和连接节点显示的是各自整棵子树的耗时,存在包含关系,不能把 7.05、7.05、6.85、6.75 和 6.21 ms 相加。按本次结果,完整查询约在 7.05 ms 返回 20 行,其中大部分时间发生在 Nested-loop 及其反复执行的订单查找中,临时表和 Top-N 排序的增量成本相对较小。
最终证据可以归纳为:
驱动节点:users,覆盖索引查找,rows=1000,loops=1
被驱动节点:orders,按 user_id 索引查找,rows=1,loops=1000
内层总工作量:约 1000 次查找、返回约 1000 行
临时结果/排序:聚合并扫描 1000 个分组,排序后返回 20 行
估算偏差最大的节点:无明显偏差
主要成本:重复执行的 orders 索引查找
六、执行算子不能混成“查询用了索引”
访问表只是执行树的一部分。连接、排序、聚合、去重和物化都可能决定主要成本。
6.1 Nested-loop 与 hash join
Nested-loop join 从外层输入取一行,再驱动内层访问。内层如果有合适索引,一次 lookup 可能很小,但总工作量还要乘以外层行数和 loops。缺少内层索引或外层估算严重偏小时,重复扫描会快速放大。
MySQL 8.4 在适合的等值连接场景中也可能采用 hash join:先从一侧构建哈希表,再用另一侧探测。它可以避免无索引等值连接的反复嵌套扫描,但构建输入大小、内存和额外过滤仍会影响成本。是否选择 hash join 以实际 TREE 计划为准,不能因为 SQL 含等号就预判。
第五章实际观察到的是带索引内层访问的 Nested-loop。Hash Join 在这里属于机制说明,不是本文已经观察到的实验结果;是否选择它必须以具体 SQL、索引、数据分布和实际 TREE 计划为准,不能为演示某个算子而引入没有建表与造数来源的对象。
6.2 filesort 和内部临时表
Using filesort 表示结果顺序不能直接由所选访问路径完整提供,需要额外排序;名称不保证一定写入磁盘。要结合排序输入行数、键宽、LIMIT 和内存/磁盘指标判断成本,而不是看到标签就增加索引。
分组、去重、窗口计算或派生表可能使用内部临时表。内部临时结果是否留在内存、何时转为磁盘以及采用何种存储取决于结果大小、类型和相关配置。计划中的 Temporary table、Materialize、聚合或排序节点需要与实际行数一起阅读。
6.3 Index Condition Pushdown
当查询使用二级索引范围、但索引中还有不能用于构造起止边界的条件时,Index Condition Pushdown(ICP)可以让存储引擎先根据索引元组判断部分条件,再决定是否读取完整行。这可能减少回表,却不等于减少了同样数量的索引条目扫描。
因此一条计划应分别记录:
- 用哪些列定位索引范围;
- 扫描多少索引条目;
- 哪些条件在索引层过滤;
- 多少候选需要回表;
- 上层连接、排序或聚合处理多少行。
七、EX-M03-03:用订单副本删除索引做因果对照
这一节要回答的不是“删除索引后慢了多少”,而是一个更基础的问题:同一份数据、同一条 SQL,仅改变索引是否存在,执行计划会发生什么变化?
为避免改动公共 orders 表,实验只操作它的副本 orders_index_lab。完整顺序是:
前置检查 → 创建并填充副本 → 有索引计划 → 删除索引计划
        → 恢复索引计划 → 核对结果 → 删除副本
7.1 前置检查
先确认公共表数据量、目标副本不存在,并记录待验证索引的准确定义:
USE mysql_lab;

SELECT COUNT(*) AS orders_count
FROM orders;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'orders_index_lab';

SHOW INDEX FROM orders
WHERE Key_name = 'idx_orders_user_created';
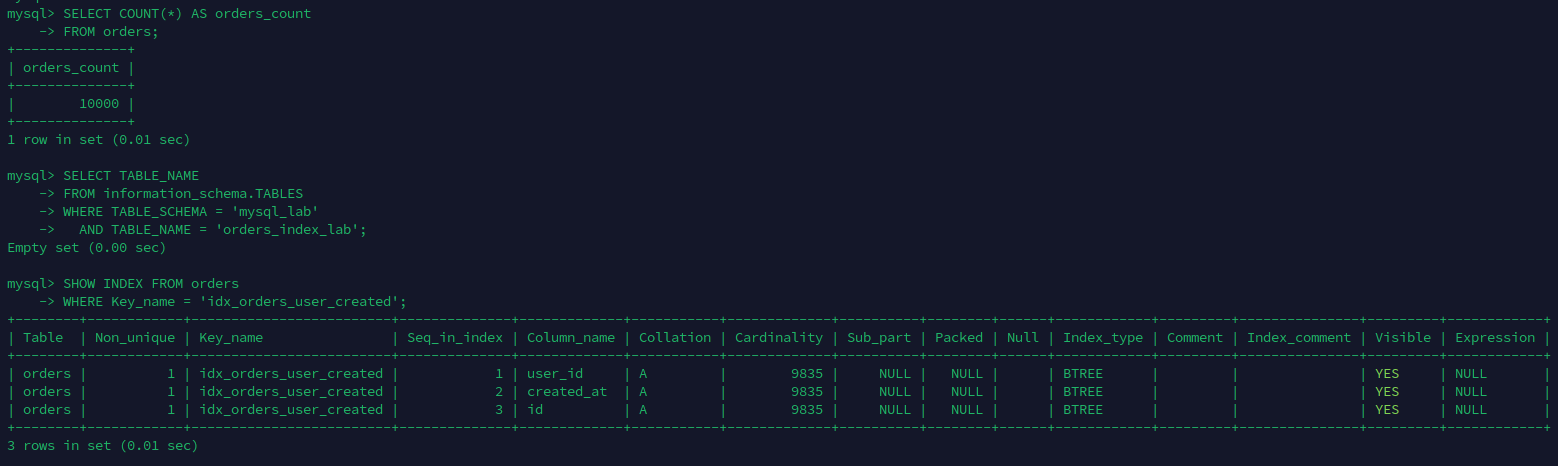
本次结果如下:
orders有10000行;orders_index_lab查询结果为空;idx_orders_user_created的列顺序是(user_id, created_at, id)。
截图中的 Cardinality=9835 是 InnoDB 根据统计信息得到的索引基数估算,不是 user_id 不同值数量的精确结果。这里使用 SHOW INDEX 的目的只是确认索引名称和列顺序;如果需要精确统计不同用户数,应单独执行 COUNT(DISTINCT user_id)。
7.2 创建实验副本
CREATE TABLE ... LIKE ... 复制表结构和索引,随后使用显式列清单复制公共数据:
CREATE TABLE orders_index_lab LIKE orders;

INSERT INTO orders_index_lab
  (id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
SELECT id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
FROM orders
ORDER BY id;

ANALYZE TABLE orders_index_lab;

SELECT COUNT(*) AS copied_rows,
       SUM(user_id = 1234) AS target_rows
FROM orders_index_lab;

SHOW INDEX FROM orders_index_lab
WHERE Key_name = 'idx_orders_user_created';
本次实验中 copied_rows=10000、target_rows=1,并且副本上存在目标索引。后面三个阶段必须使用完全相同的查询:
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;
target_rows=1 决定了这一实验的解释边界:它适合验证高选择性点查在有无索引时的访问路径差异,但不能用于衡量大量候选行排序的成本,也不能验证 LIMIT 20 读取到第 20 行后提前停止的收益。
7.3 阶段一:保留索引
同时保存静态计划和实际执行计划。FORMAT=TREE 便于看计划结构,EXPLAIN ANALYZE 用于核对实际行数、循环次数和时间:
EXPLAIN FORMAT=TREE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;

EXPLAIN ANALYZE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;
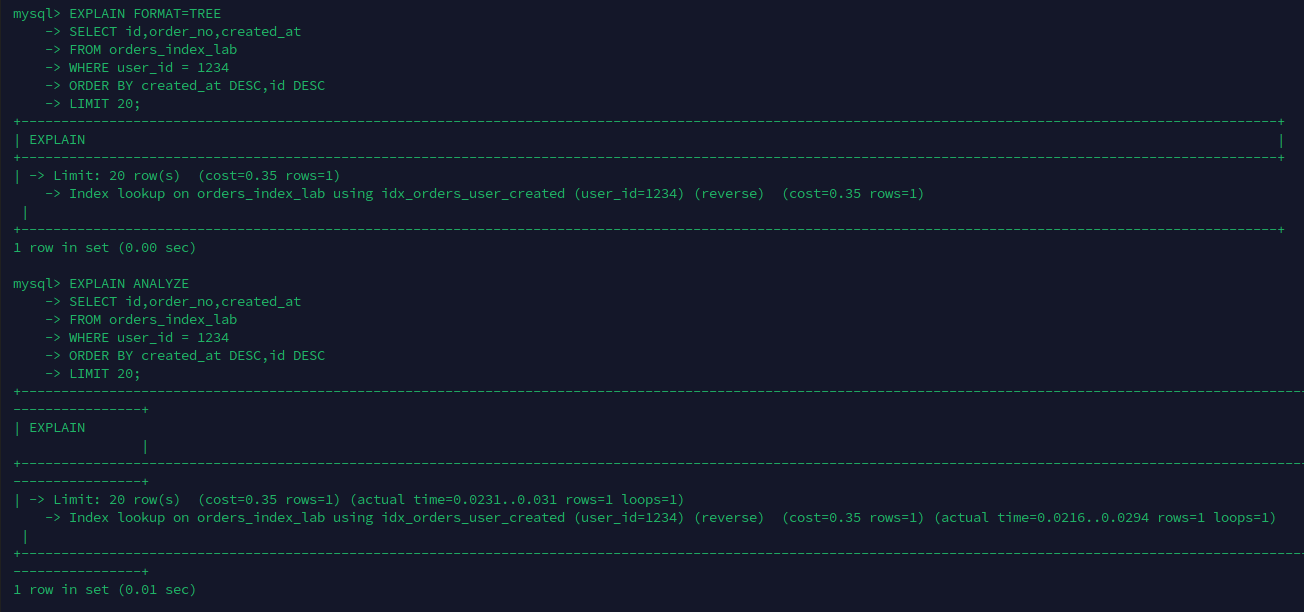
计划中的 Index lookup ... (reverse) 表示先用 user_id=1234 定位 idx_orders_user_created 的等值范围,再沿索引反向遍历。因为 user_id 已固定,反向遍历剩余的 (created_at,id) 正好得到 created_at DESC,id DESC,所以不需要显式排序。
访问节点估算和实际都返回 1 行,loops=1。根节点的 actual time=0.0231..0.031 单位为毫秒:0.0231 ms 是返回首行的时间,0.031 ms 才是该节点完成的时间。由于 order_no 不在该二级索引中,即使使用索引,查询仍需要根据索引记录中的主键读取完整记录;“使用索引定位”和“覆盖索引”不能混为一谈。
7.4 阶段二:删除索引
只删除副本上的索引,并立即确认删除结果:
ALTER TABLE orders_index_lab
  DROP INDEX idx_orders_user_created;

SHOW INDEX FROM orders_index_lab
WHERE Key_name = 'idx_orders_user_created';

ANALYZE TABLE orders_index_lab;

EXPLAIN FORMAT=TREE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;

EXPLAIN ANALYZE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;
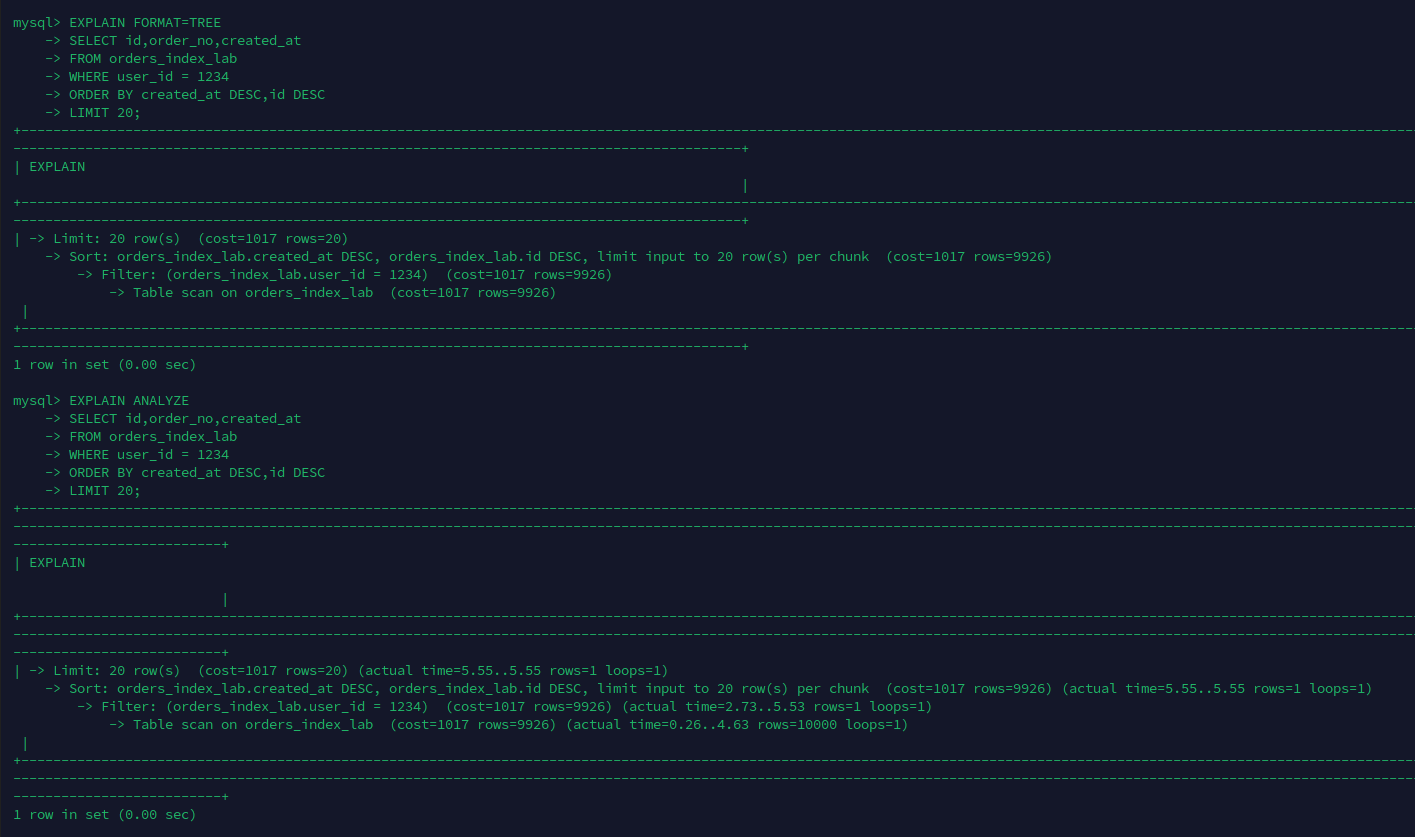
删除唯一以 user_id 开头的索引后,访问路径变为 Table scan。表扫描节点估算读取 9926 行、实际读取 10000 行,这里的 9926 来自表统计估算,不是精确行数。
更明显的偏差发生在 Filter 节点:优化器仍估算它输出 9926 行,实际却只有 1 行,约高估 9926 倍。该计划说明优化器没有把 user_id=1234 估算为高选择性条件;不能反过来解释成“统计信息已经清楚该值只有一行”。
过滤完成后出现 Sort ... limit input to 20 row(s) per chunk,说明无法利用索引顺序,需要执行带 LIMIT 20 的 Top-N 排序。但本次 Filter 实际只输出 1 行,因此排序节点也只处理并返回 1 行,不能据此证明排序产生了显著开销。根节点完成时间为 5.55 ms,而 Filter 在 5.53 ms 完成,主要工作来自扫描和过滤全部 10000 行。计划中的 cost=1017 是优化器成本值,不是毫秒。
7.5 阶段三:按原定义恢复索引
恢复不是多余步骤。它用于验证性能变化确实由该索引引起,也训练我们在生产变更中完成“变更—验证—回退验证”的闭环:
ALTER TABLE orders_index_lab
  ADD KEY idx_orders_user_created (user_id,created_at,id);

ANALYZE TABLE orders_index_lab;

SHOW INDEX FROM orders_index_lab
WHERE Key_name = 'idx_orders_user_created';

EXPLAIN FORMAT=TREE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;

EXPLAIN ANALYZE
SELECT id,order_no,created_at
FROM orders_index_lab
WHERE user_id = 1234
ORDER BY created_at DESC,id DESC
LIMIT 20;
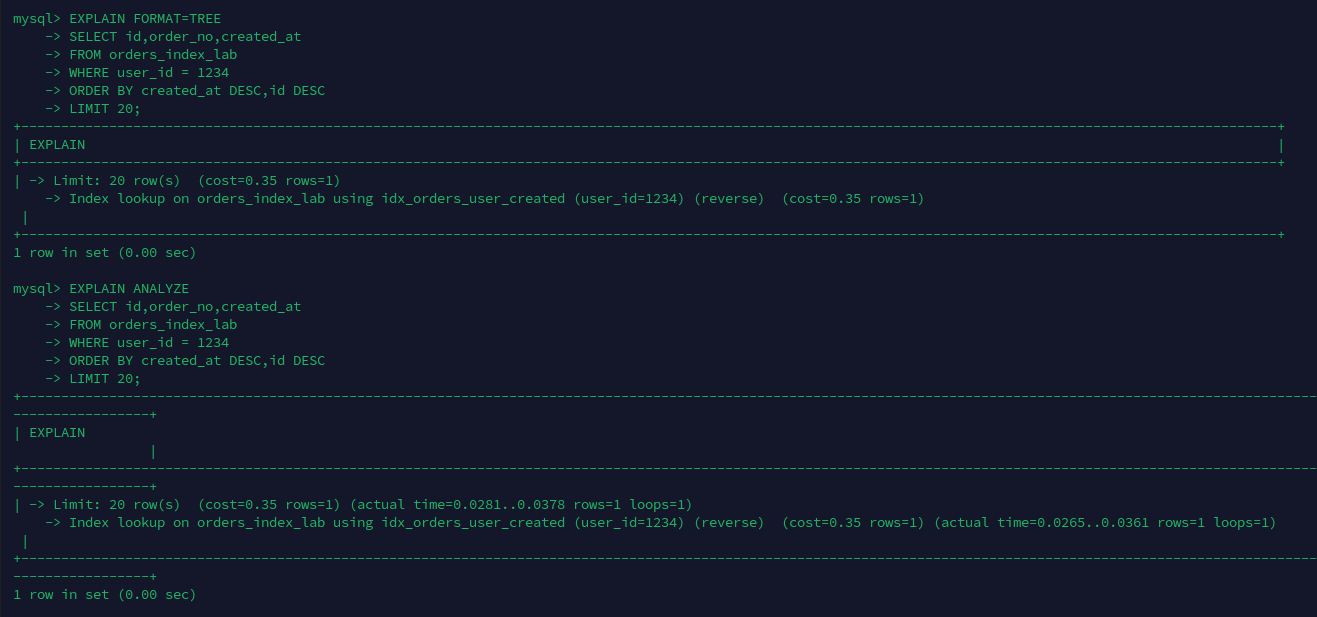
恢复后的索引列顺序再次是 (user_id, created_at, id),访问路径也恢复为反向 Index lookup:估算和实际都是 1 行,loops=1,没有显式排序。根节点 actual time=0.0281..0.0378 ms,与第一次的 0.0231..0.031 ms 处于同一量级,但两次单次执行并不完全相等,也不足以推导稳定的耗时差异。
7.6 汇总结果并解释
为避免把不同节点的数据混在一起,访问行数统一取最底层访问节点,过滤行数取 Filter 节点,时间保留根节点完整的“首行时间..完成时间”:
| 阶段 | 访问路径/索引 | 访问节点估算/实际 | Filter 估算/实际 | 排序 | loops |
根节点 actual time |
|---|---|---|---|---|---|---|
| 有索引 | reverse Index lookup / idx_orders_user_created |
1/1 | — | 无 | 1 | 0.0231..0.031 ms |
| 删除索引后 | Table scan / 无 | 9926/10000 | 9926/1 | Top-N,实际候选 1 行 | 1 | 5.55..5.55 ms |
| 恢复索引后 | reverse Index lookup / idx_orders_user_created |
1/1 | — | 无 | 1 | 0.0281..0.0378 ms |
分析时按以下顺序进行:
- 先看访问路径是否由索引查找变成表扫描;
- 再看为得到同一行结果,底层实际读取了多少行;
- 检查删除索引后是否新增排序节点;
- 最后比较时间,并核对恢复后的计划是否回到初始状态。
删除索引后,访问路径由反向索引点查变为全表扫描,底层实际读取行数从 1 增加到 10000,并出现 Top-N 排序节点;恢复索引后,访问路径、读行数量和排序行为都恢复到初始状态。SQL 和数据保持不变,只有目标索引经历“存在 → 删除 → 恢复”,因此这组结果能够证明访问路径变化由该索引引起。
耗时只能作为辅助观察值。第一次和恢复后的完成时间分别为 0.031 ms、0.0378 ms,只能认为处于同一量级;缓存、DDL 后的系统状态以及计时抖动都可能影响单次结果。无索引阶段虽然显示 5.55 ms,也不应据此计算可推广到其他数据量和并发条件的固定性能倍数。
此外,本次条件只命中 1 行,所以新增 Sort 节点是“排序路径发生变化”的证据,而不是“大量排序成为性能瓶颈”的证据。若要验证索引有序扫描配合 LIMIT 20 的提前停止效果,应另行构造单个用户至少拥有 20 笔订单的数据集,不与本次点查实验混为一谈。
7.7 清理并确认公共表未被修改
DROP TABLE orders_index_lab;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'orders_index_lab';

SELECT COUNT(*) AS orders_count
FROM orders;

SHOW INDEX FROM orders
WHERE Key_name = 'idx_orders_user_created';
本次清理与复核均已通过:副本查询为空,公共 orders 仍有 10000 行且目标索引仍然存在,因此 EX-M03-03 状态记为 PASSED。还要注意,ALTER TABLE 和 DROP TABLE 属于 DDL,可能隐式提交当前事务,因此不要把该实验夹在其他待提交事务中执行。
八、EX-M03-04:用倾斜数据区分索引统计与 Histogram
这一节要区分两个容易混淆的问题:
- 优化器对条件命中行数的估算是否准确;
- 优化器是否拥有能减少读行数量的访问路径。
公共 orders.state 已包含在复合索引中,而且样例数据分布较均匀,不适合演示 histogram。这里改用未建索引的 total_amount,并在独立副本 orders_stats_lab 中构造 99:1 的稳定倾斜分布:9900 行金额为 100.00,100 行金额为 1000.00。
实验顺序如下:
创建倾斜数据 → 原始计划 → ANALYZE TABLE 后计划
             → 创建 histogram 后计划 → 删除 histogram 和副本
8.1 创建受控数据
先确认副本不存在,再复制公共数据并只修改副本:
USE mysql_lab;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'orders_stats_lab';

CREATE TABLE orders_stats_lab LIKE orders;

INSERT INTO orders_stats_lab
  (id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
SELECT id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
FROM orders
ORDER BY id;

UPDATE orders_stats_lab
SET total_amount = CASE
    WHEN MOD(id,100) = 0 THEN 1000.00
    ELSE 100.00
END;

SELECT total_amount,COUNT(*) AS rows_per_value
FROM orders_stats_lab
GROUP BY total_amount
ORDER BY total_amount;
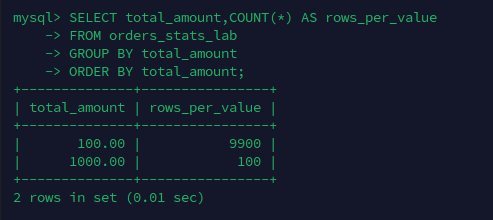
本次结果严格为 100.00 → 9900 行、1000.00 → 100 行,说明目标值 1000.00 占总数据的 1%。这个精确比例为后续判断优化器估算是否准确提供了实际基准。接着确认实验列没有索引,也没有遗留 histogram:
SELECT INDEX_NAME,SEQ_IN_INDEX,COLUMN_NAME
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'orders_stats_lab'
  AND COLUMN_NAME = 'total_amount';

SELECT TABLE_NAME,COLUMN_NAME
FROM information_schema.COLUMN_STATISTICS
WHERE SCHEMA_NAME = 'mysql_lab'
  AND TABLE_NAME = 'orders_stats_lab'
  AND COLUMN_NAME = 'total_amount';
两条查询都应返回空结果。如果不是,应先查清副本的来源,避免把旧实验状态带入本次对照。
8.2 固定查询与观察位置
三个阶段都执行完全相同的 SQL:
SELECT *
FROM orders_stats_lab
WHERE total_amount = 1000.00;
由于 total_amount 没有索引,重点观察 EXPLAIN ANALYZE 中两个节点:
Table scan on orders_stats_lab:实际扫描多少行,预期约为10000;Filter: (orders_stats_lab.total_amount = 1000.00):估算和实际输出多少行,实际应为100。
不要用 Filter 节点的 rows=100 表示只扫描了 100 行。Filter 的输出行数和其子节点的扫描行数描述的是不同阶段。
8.3 阶段一:记录原始计划
EXPLAIN ANALYZE
SELECT *
FROM orders_stats_lab
WHERE total_amount = 1000.00;
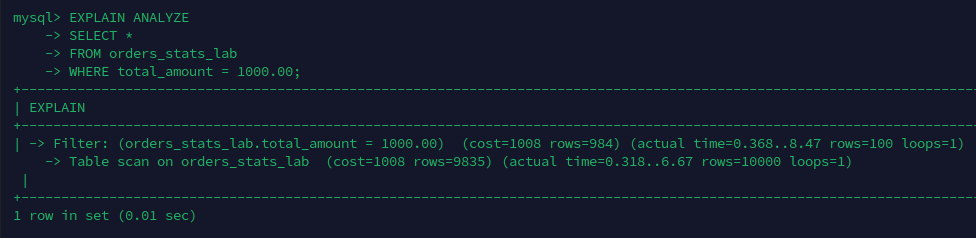
原始计划包含两个节点:
Table scan估算读取9835行、实际读取10000行,表基数估算比实际少165行,约低估1.65%;- Filter 估算输出
984行、实际输出100行,估算值是实际值的9.84倍。
984 约等于表估算行数 9835 的 10%。这说明在本次没有 histogram 的计划中,优化器为该等值条件采用了约 10% 的过滤选择率;这只是从本次输出得到的观察,不应推广成所有无索引等值条件都固定按 10% 估算。
根节点 actual time=0.368..8.47:0.368 ms 是 Filter 返回首行的时间,8.47 ms 是完成过滤的时间。Filter 的子节点仍实际扫描了整张表,不能因为最终只返回 100 行就认为只读取了 100 行。
8.4 阶段二:只刷新常规统计信息
ANALYZE TABLE orders_stats_lab;

EXPLAIN ANALYZE
SELECT *
FROM orders_stats_lab
WHERE total_amount = 1000.00;
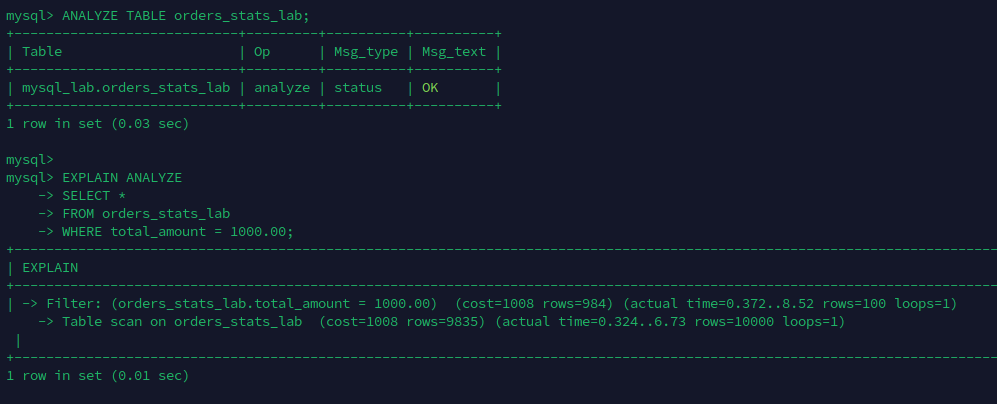
ANALYZE TABLE 返回 status=OK,但执行计划中的关键估算没有发生变化:表扫描仍是 9835 行,Filter 仍是 984 行,实际值则分别为 10000 行和 100 行。根节点时间为 0.372..8.52 ms,与原始阶段的 0.368..8.47 ms 处于同一量级。
这说明普通 ANALYZE TABLE 虽然刷新了表和索引相关统计信息,但没有让优化器掌握未建索引列 total_amount 的 99:1 倾斜分布。它也不会自动创建一条新的访问路径,因此本阶段仍然执行全表扫描。两次耗时相差 0.05 ms,属于单次执行中可能出现的小幅波动,不能解释成普通 ANALYZE TABLE 导致查询变慢。
8.5 阶段三:创建 histogram 后再次执行
ANALYZE TABLE orders_stats_lab
  UPDATE HISTOGRAM ON total_amount
  WITH 16 BUCKETS;

SELECT COLUMN_NAME,
       HISTOGRAM->>'$."histogram-type"' AS histogram_type,
       HISTOGRAM->>'$."number-of-buckets-specified"' AS buckets_specified,
       HISTOGRAM->>'$."sampling-rate"' AS sampling_rate,
       HISTOGRAM->>'$."last-updated"' AS last_updated
FROM information_schema.COLUMN_STATISTICS
WHERE SCHEMA_NAME = 'mysql_lab'
  AND TABLE_NAME = 'orders_stats_lab'
  AND COLUMN_NAME = 'total_amount';

EXPLAIN ANALYZE
SELECT *
FROM orders_stats_lab
WHERE total_amount = 1000.00;
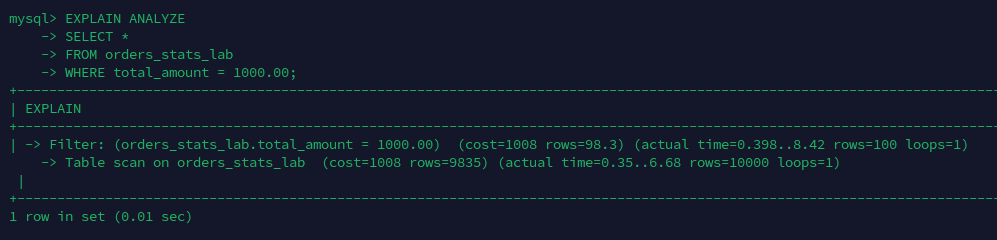
创建 histogram 后,Filter 估算从 984 行降为 98.3 行,实际仍为 100 行,估算/实际由 9.84 改善到 0.983。98.3 正好约为表估算行数 9835 的 1%,与受控数据中目标值的真实占比一致,说明优化器已经利用列值分布修正过滤选择率。
与此同时,表扫描节点仍估算 9835 行、实际读取 10000 行,访问路径也仍是 Table scan。根节点时间为 0.398..8.42 ms,没有表现出稳定的耗时下降。这正是本实验需要区分的两件事:histogram 改善了“预计有多少行满足条件”,却没有提供“如何直接定位这些行”的能力。
COLUMN_STATISTICS 的输出用于证明 histogram 已实际创建,并记录类型、桶数、采样率和更新时间。当前截图主要展示创建后的执行计划;如果需要形成完整审计证据,还应保留该元数据查询的终端输出。
8.6 汇总结果并得出结论
| 阶段 | 访问路径 | 表扫描估算/实际 | Filter 估算/实际 | 估算/实际 | 根节点 actual time |
计划是否改变 |
|---|---|---|---|---|---|---|
| 原始 | Table scan | 9835/10000 | 984/100 | 9.84 | 0.368..8.47 ms |
基线 |
ANALYZE TABLE 后 |
Table scan | 9835/10000 | 984/100 | 9.84 | 0.372..8.52 ms |
否 |
| histogram 后 | Table scan | 9835/10000 | 98.3/100 | 0.983 | 0.398..8.42 ms |
否 |
其中“估算/实际”可直接计算为:
Filter 节点估算行数 ÷ Filter 节点实际行数
越接近 1,说明基数估算越准确。本次结果可以得到以下结论:
- 原始阶段把真实占比
1%的条件估成约10%,Filter 输出行数被高估为实际值的9.84倍; - 普通
ANALYZE TABLE后估算没有变化,说明刷新常规表和索引统计不足以描述本实验中未建索引列的倾斜分布; - histogram 后估算变为实际值的
0.983倍,误差从高估884%降为低估约1.7%; - 三个阶段都扫描了
10000行,执行计划始终是全表扫描,完成时间也都在约8.4~8.5 ms,因此本次查询没有获得可观察的执行性能提升。
这并不意味着更准确的估算没有价值。在多表连接或存在多个候选访问路径时,过滤结果究竟是约 984 行还是约 98.3 行,可能影响连接顺序、连接算法和总体成本比较;当前单表查询没有其他可选路径,所以计划保持不变。
因此,本节不能得出“创建 histogram 可以代替索引”的结论。索引解决的是如何少读数据;histogram 解决的是优化器如何更准确地预测过滤后会留下多少数据。
8.7 清理 histogram 和实验副本
显式删除 histogram,用查询确认后再删除副本:
ANALYZE TABLE orders_stats_lab
  DROP HISTOGRAM ON total_amount;

SELECT TABLE_NAME,COLUMN_NAME
FROM information_schema.COLUMN_STATISTICS
WHERE SCHEMA_NAME = 'mysql_lab'
  AND TABLE_NAME = 'orders_stats_lab'
  AND COLUMN_NAME = 'total_amount';

DROP TABLE orders_stats_lab;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN ('orders_index_lab','orders_stats_lab');

SELECT COUNT(*) AS orders_count
FROM orders;

SHOW INDEX FROM orders
WHERE Key_name = 'idx_orders_user_created';
本次 histogram 删除、副本清理和公共表复核均已通过:删除 histogram 后,COLUMN_STATISTICS 查询结果为空;orders_stats_lab 已不存在;公共 orders 仍有 10000 行,idx_orders_user_created 也仍然存在。因此 EX-M03-04 状态记为 PASSED。
8.8 本实验验收
本实验最终满足以下条件:
orders_stats_lab创建后为10000行,金额分布严格为9900:100;- 三个阶段的表扫描节点都实际读取
10000行,Filter 节点都实际输出100行; - histogram 创建后可在
COLUMN_STATISTICS中查询到,显式删除后查询结果为空; orders_stats_lab清理后不存在,公共orders的行数和索引定义保持不变。
九、EX-M03-05:索引提示只用于验证假设
待实验
本节给出索引提示的诊断原则,尚未补充本机对照结果,因此证据地图保持 NOT_STARTED。
FORCE INDEX 对照回答的是:如果强制走该路径,实际工作量是否更低?它不自动回答:这个提示在数据增长和分布变化后是否仍正确。
这组诊断必须包含:
- 优化器原计划;
- 强制计划;
- 两者实际扫描与耗时;
- 原计划原因;
- 长期修复是统计、索引、SQL 还是数据模型调整。
提示的价值是做诊断实验:强制候选索引后,如果扫描工作量明显更小,说明优化器的估算或成本判断需要进一步解释;如果强制后更慢,则推翻了“看到某个索引就应该用”的假设。长期把 FORCE INDEX 写入业务 SQL 会冻结当前假设,日后数据分布、索引或版本变化时可能反而阻止更好的计划。
十、固定诊断顺序
确认 SQL 与业务目标
→ 确认数据量和分布
→ 查看索引与统计
→ EXPLAIN 预测路径
→ EXPLAIN ANALYZE 对照实际
→ 定位行数、循环、排序或回表成本
→ 做单变量修改
→ 重复同条件验证
十一、综合任务:为复合订单查询选择索引
这一任务要求把本章的分析方法应用到新的查询场景,而不是迁移数据或数据库。业务需求是:“查询最近 30 天、金额大于 500 的已支付订单,按金额倒序取前 100 条。”为了让金额相同时的结果顺序稳定,增加 id DESC 作为第二排序列:
SET @start_at = TIMESTAMP('2025-12-01 00:00:00');
SET @end_at   = TIMESTAMP('2025-12-31 00:00:00');

SELECT id,order_no,total_amount,created_at
FROM orders
WHERE state = 20
  AND created_at >= @start_at
  AND created_at < @end_at
  AND total_amount > 500
ORDER BY total_amount DESC,id DESC
LIMIT 100;
这里使用与公共样例数据匹配的固定半开时间区间,避免使用 NOW() 后因执行日期不同而得到空结果。生产查询则应由应用传入对应的起止时间。
这条查询同时包含状态等值、时间范围、金额范围、金额排序和 LIMIT,不存在脱离数据分布的唯一索引答案。至少需要比较下面两个方向:
| 候选 | 主要定位方式 | 排序能力 | 更可能有利的分布 | 主要风险 |
|---|---|---|---|---|
A:(state,created_at,total_amount,id) |
固定状态后扫描 30 天时间范围 | created_at 范围位于金额之前,通常仍需按金额和 ID 排序 |
最近 30 天只占全表很小比例 | 时间范围内订单很多时,过滤后仍需排序 |
B:(state,total_amount,id,created_at) |
固定状态后按高金额方向扫描 | 可按 total_amount DESC,id DESC 读取,并可能提前满足 LIMIT 100 |
高金额订单稀少,且较快找到 100 条近期记录 | 近期订单占比很低时,可能扫描并过滤大量过期高金额记录 |
两个候选都没有包含投影列 order_no,因此即使过滤和排序使用二级索引,最终候选仍需回表读取订单号。是否为了覆盖查询把 order_no 加入索引,还要单独衡量索引宽度、写放大和实际回表数量,不能直接作为默认设计。
完成这一任务前,至少要先取得四项分布:已支付订单数、最近 30 天订单占比、金额大于 500 的占比,以及三个条件同时成立的行数。随后为基线和两个候选方案分别记录访问路径、估算与实际行数、过滤位置、排序输入、loops 和根节点时间。
最终答案不能只写“等值列在前、范围列在后”。它需要说明哪个条件真正缩小了扫描范围、哪个方案能够利用索引顺序、LIMIT 100 是否让读取提前停止,以及另一方案为何在当前数据分布下被淘汰。数据分布变化后,这个结论也需要重新验证。
十二、本章结论
12.1 读取执行计划的方法
- 普通
EXPLAIN展示优化器的预测,EXPLAIN ANALYZE实际执行查询并补充每个迭代器的实测信息;cost是成本值,不是毫秒。 - TREE 计划应从叶子节点向上读取,先确认数据怎样被访问,再观察过滤、连接、聚合、排序和
LIMIT如何消费下层结果。 rows是每轮平均返回行数,loops是执行轮数;多轮内层访问的总工作量需要结合rows × loops理解。actual time=first..all分别表示每轮返回首行和完成迭代的平均时间。父节点包含子节点工作,不能把整棵树的时间直接相加。- 访问节点读取多少行与 Filter 最终输出多少行是两个口径;返回行数很少,并不代表底层读取也很少。
12.2 本文已经验证的结果
| 实验 | 关键观察 | 可以支持的结论 |
|---|---|---|
| EX-M03-01 | 索引范围估算为 500 行,实际在 Limit 消费 20 行后停止 |
下层估算描述完整范围,受 LIMIT 提前终止后的实际返回行不能直接作为估算误差 |
| EX-M03-02 | users 返回 1000 行,orders 每轮返回 1 行并执行 1000 轮 |
Nested-loop 的主要工作量来自被驱动节点的重复执行,不能只看每轮 rows=1 |
| EX-M03-03 | 删除索引后由读取 1 行的反向索引点查变为扫描 10000 行并排序,恢复后计划复原 |
单变量“删除—恢复”对照可以把访问路径变化归因于目标索引 |
| EX-M03-04 | 普通 ANALYZE TABLE 后 Filter 仍估算 984 行;histogram 后估算为 98.3 行,实际为 100 行 |
histogram 能修正未索引列的选择率估算,但不会创建访问路径,三个阶段仍扫描 10000 行 |
12.3 优化结论的工程边界
ALL不必然意味着计划错误;如果查询需要读取大部分数据,全表扫描可能就是成本更低的选择。Using filesort只表示需要额外排序,不能据此断定发生磁盘排序,也不能忽略排序输入规模和LIMIT。- 索引解决的是如何减少访问数据,统计信息和 histogram 解决的是如何估算数据;二者不能互相替代。
FORCE INDEX适合验证“某个候选路径是否减少实际工作量”,不适合作为缺少证据时的长期默认方案。- 单次耗时会受到缓存、后台刷盘、DDL 和系统负载影响。访问路径、读行数量、过滤比例、排序和循环次数通常是更稳定的第一层证据。
12.4 尚未完成的验证
EX-M03-01 至 EX-M03-04 已完成并通过,剩余的 EX-M03-05 需要保存普通计划和强制索引计划,比较实际扫描行数、排序、loops 与耗时,并解释提示为何更好或更差。只有完成这一对照,才能把索引提示从机制说明提升为本文的实测结论。
一份可复查的优化结论最终应回答:哪个节点发生错估,实际读取了多少行,循环放大了多少工作,修改了哪一个变量,复测是否改善,以及如何清理或回退实验变更。