MySQL 8.4 实战(二):主键选择与 B+Tree 索引设计
从 InnoDB 聚簇索引和二级索引结构出发,比较递增主键、全局 64 位 ID 与随机二进制 ID,并建立面向查询的联合索引设计方法。
上一篇已经建立了订单公共模型。本文接着回答:这些索引怎样组织订单,能否支撑原先声明的查询,以及换一种主键会带来什么变化。请先完成第一篇的造数和实验清理,保留四张各有 10,000 行的公共表。
主键设计并不只影响主键查询。在 InnoDB 中,主键决定聚簇索引的组织方式,主键值还会进入二级索引叶子节点。因此,主键的宽度、顺序性和生成方式会同时影响插入局部性、页利用率和所有二级索引。
一、本文要解决的问题
- 为什么 InnoDB 主键会影响整张表?
- 递增
BIGINT、全局 64 位 ID、随机BINARY(16)如何选择? - 联合索引为什么必须从真实查询推导?
- 最左前缀、范围、排序、覆盖和回表之间是什么关系?
- 如何用执行计划和空间数据证明索引是否有效?
二、实验索引
EX-M02-01 表示“实验(EX)—系列第二篇(M02)—本模块第 01 个实验”。本篇编号与正文一一对应:
| 实验 | 验证目标 | 正文位置 |
|---|---|---|
| EX-M02-01 | 观察现有索引的列顺序、唯一性和统计基数 | §3.1 |
| EX-M02-02 | 对照最左前缀、范围、排序和覆盖访问 | §六 |
| EX-M02-03 | 对照表达式、函数和前置通配符的访问路径 | §七 |
| EX-M02-04 | 使用订单副本比较三类主键的插入耗时与空间占用 | §八 |
三、先建立 InnoDB 索引模型
InnoDB 表的行数据组织在聚簇索引中。有显式主键时,主键就是聚簇索引;没有主键时,InnoDB 会寻找适合的非空唯一索引,否则创建隐藏的 GEN_CLUST_INDEX。这也是建表时应主动指定稳定主键的原因:不要把行组织方式交给隐式规则。
简化模型如下:
PRIMARY KEY(id)
  B+Tree 叶子:完整行

SECONDARY KEY(tenant_id, state, created_at, id)
  B+Tree 叶子:二级索引列 + 主键值
                          ↓
                    回到聚簇索引
这张图需要配合四个边界理解:
- B+Tree 有序性支持点查、范围和有序遍历;
- 聚簇索引描述数据行与主键索引的组织关系;
- 二级索引命中不等于不回表;
- 叶子节点已经包含主键时,显式把主键列放进索引定义不应被简化为“一定节省回表”。要根据
SHOW INDEX、实际投影列和排序稳定性分析。
B+Tree 并不等于“查询都是 O(log N)”。定位起点之后仍要遍历匹配范围,二级索引查询还可能对每个候选主键回到聚簇索引。因此总工作量更接近“定位 + 扫描候选 + 回表/过滤”,选择性低时优化器也可能合理地改用全表扫描。
3.1 EX-M02-01:观察现有索引与基数
这个实验复用 M01 创建的 orders 表。执行前先根据 DDL 写下每个索引的列顺序、是否唯一,以及它可能服务的查询,再查看数据字典和当前统计信息:
USE mysql_lab;

SELECT
  (SELECT COUNT(*) FROM users) AS users_count,
  (SELECT COUNT(*) FROM orders) AS orders_count,
  (SELECT COUNT(*) FROM order_items) AS items_count,
  (SELECT COUNT(*) FROM payments) AS payments_count;

SHOW INDEX FROM orders;

SELECT INDEX_NAME, COLUMN_NAME, SEQ_IN_INDEX, CARDINALITY,
       INDEX_TYPE, NON_UNIQUE
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME = 'orders'
ORDER BY INDEX_NAME, SEQ_IN_INDEX;

SELECT COUNT(*) AS total_rows,
       COUNT(DISTINCT user_id) AS exact_user_id,
       COUNT(DISTINCT tenant_id) AS exact_tenant_id,
       COUNT(DISTINCT state) AS exact_state
FROM orders;
先核验四张表均为 10,000 行,订单的精确用户数、租户数和状态数分别为 10,000、10、4。然后还原 PRIMARY、uk_orders_order_no、idx_orders_user_created 和 idx_orders_tenant_state_created 的列顺序,并区分 NON_UNIQUE 表达的唯一性与 CARDINALITY 表达的估算基数。COUNT(DISTINCT ...) 是当前数据的精确计算,二者数值不同不表示索引损坏。
四、三类主键的选择框架
| 方案 | 宽度 | 顺序性 | 跨节点唯一 | 主要风险 | 适用前提 |
|---|---|---|---|---|---|
AUTO_INCREMENT BIGINT |
8 字节 | 递增 | 单实例内 | 分片后需重新设计 | 单写入口或单实例 |
| 全局 64 位 ID | 8 字节 | 通常近似有序 | 是 | 时钟、节点号和生成器可用性 | 分布式 ID 服务可靠 |
随机 BINARY(16) |
16 字节 | 随机 | 概率保证 | 索引更宽、写入局部性较差 | 确有随机 ID 需求,且能处理碰撞 |
这张表是设计假设,不是性能结论。先用现有订单验证索引的读路径,再在 §八的 EX-M02-04 中用相同业务字段和二级索引定义、1,000,000 行的扩展订单源对照三类主键。
4.1 宽度会沿二级索引放大
主键不仅出现在 PRIMARY B+Tree。二级索引叶子用主键值指向聚簇记录,所以主键从 8 字节变为 16 字节时,表上每个二级索引都会承受更宽的条目。更宽的条目意味着每页可容纳的键更少,可能增加页数、缓存占用和 I/O。但具体放大倍数还受行格式、页利用率、其他列宽度和数据压缩影响,必须实测。
4.2 顺序性影响写入局部性
递增或大致有序的主键倾向把新记录写到 B+Tree 右侧热区,随机主键则更可能分散到已有页,导致页分裂和更差的缓存局部性。但“递增必然更快”也不是无条件结论:高并发单点写入可能产生热页竞争,全局 ID 生成器又引入时钟、节点号和可用性边界。选型要在数据库局部性、跨节点唯一性和运维复杂度之间取舍。
五、联合索引从查询形状推导
第一篇声明了“根据租户和状态处理订单”的访问模式。现在以租户 2 的已支付订单列表为例,倒序读取最近 20 笔订单;20 沿用第一篇的已支付状态码:
SELECT id,order_no,total_amount,created_at
FROM orders
WHERE tenant_id=2 AND state=20
ORDER BY created_at DESC,id DESC
LIMIT 20;
第一篇已经为这类查询创建了联合索引,以下是它的定义,无需再次执行建索引操作:
KEY idx_orders_tenant_state_created (tenant_id,state,created_at,id)
索引的列顺序来自查询形状:
tenant_id,state如何缩小连续范围;created_at,id如何提供组内顺序;LIMIT如何让扫描提前停止;- 查询还需要
order_no和total_amount时是否回表; - 为覆盖而继续加宽索引会增加多少写入和空间成本。
tenant_id,state 都是等值条件,可以定位一个租户内某种状态的连续区间。created_at,id 紧随其后,提供组内顺序;B+Tree 可反向遍历,不必因 DESC 就自动认定需要额外排序。id 用于打破相同时间值的并列关系。继续翻页时,还应把上一页末行的时间和 ID 作为游标条件。下面是应用中的参数化查询片段,问号由客户端绑定:
WHERE tenant_id = ? AND state = ?
  AND (created_at,id) < (?,?)
ORDER BY created_at DESC,id DESC
LIMIT 20;
InnoDB 二级索引叶子本就携带主键,显式把 id 放进索引定义是否增加能力要用 SHOW INDEX 和计划验证,不能仅凭 DDL 外观判断。本例保留它是为了让分页键在设计上可见;若去掉显式 id 后计划与顺序能力相同,可使用更精简的定义。
只有索引中已包含查询所需的全部列时,才可能形成覆盖访问。将 order_no,total_amount 都追加进索引可能消除这条查询的回表,但会让每笔订单写入和金额更新维护更宽的索引。低频查询或小范围回表通常不值得为此牺牲所有写入。
六、EX-M02-02:验证最左前缀、范围、排序与覆盖
第一篇的数据是一名用户对应一笔订单,按用户点查难以展示列表扫描。按租户和状态查询则有足够的候选记录,可以直接用公共表验证上面的推导。先核验本节使用的数据范围:
SELECT COUNT(*) AS paid_candidates,
       SUM(created_at >= '2024-02-01'
           AND created_at < '2024-03-01') AS february_candidates
FROM orders
WHERE tenant_id = 2 AND state = 20;
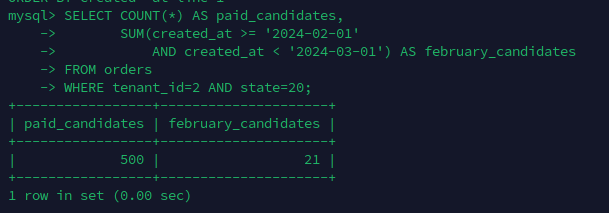
沿用第一篇的完整基线时,两个结果应为 500 和 21。租户与状态由同一个用户 ID 取模派生,并非独立分布,因此不能随意换一个租户后假定仍有同样的候选量。如果结果不符,先检查前序实验的数据和状态编码。
确认前提后,预测每条查询的 key、访问类型、扫描量级、排序方式和是否覆盖,再依次对照普通 EXPLAIN 与 EXPLAIN ANALYZE。前者展示优化器选择的路径和估算,后者会实际执行查询并展示迭代器的实际行数;本节的四条语句都是只读查询。
6.1 等值前缀、倒序读取与覆盖访问
先固定联合索引的前两列,再按后两列倒序取最近 20 笔订单:
EXPLAIN FORMAT=TRADITIONAL
SELECT id, created_at
FROM orders
WHERE tenant_id = 2 AND state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
tenant_id,state 构成等值前缀,可以将访问限制在 (tenant_id=2,state=20) 的连续索引范围。该范围内的记录按 created_at,id 排列,因此执行器可以反向遍历索引,从最新记录开始读取。过滤列、排序列和返回列都在 idx_orders_tenant_state_created 中,预期形成覆盖访问。
普通计划:
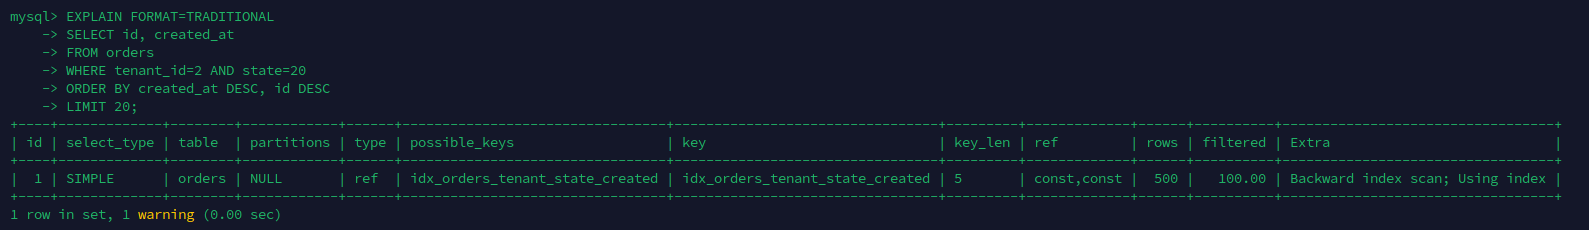
Backward index scan 表示反向遍历这段索引范围,不是先正向读取 500 行再反转结果;Using index 表示该查询可以从二级索引取得所需列。这里的 rows=500 是候选范围的估算值,不是本次执行已经扫描了 500 行。继续执行实际计划,核对 LIMIT 是否让访问节点在产生 20 行后停止:
EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE tenant_id = 2 AND state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
实际计划:
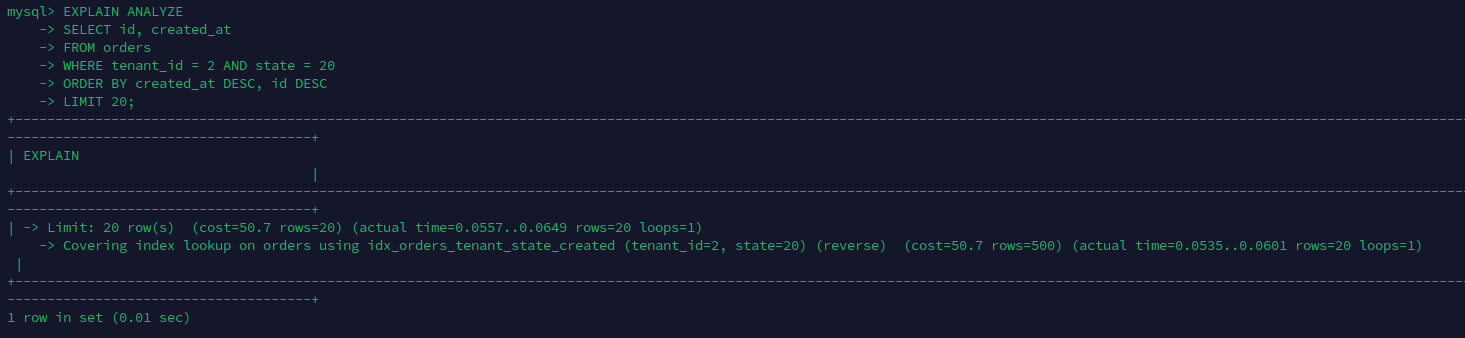
最外层 Limit 的估算和实际输出都是 20 行,loops=1。下层访问显示为 Covering index lookup ... (reverse):优化器估计等值范围中有 500 行,但索引访问节点实际只向上层产生 20 行,说明执行器按索引逆序读取,并在 Limit 得到足够结果后停止,没有遍历完整的 500 行候选范围。
计划中既没有 Sort 节点,也没有普通的非覆盖 Index lookup,验证了索引同时承担定位、排序和投影。这里可以把实际工作描述为“覆盖索引逆序读取 20 行”,而不能根据普通 EXPLAIN 的 rows=500 说实际扫描了 500 行。
6.2 缺少最左列与 Index Skip Scan
省略 tenant_id 前,先确认公共数据中 state=20 的租户分布:
SELECT tenant_id, COUNT(*) AS paid_count
FROM orders
WHERE state = 20
GROUP BY tenant_id
ORDER BY tenant_id;
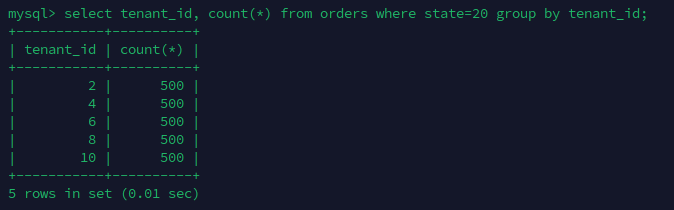
基线数据中的 2500 笔已支付订单分布在租户 2/4/6/8/10,每个租户 500 笔。再查看省略联合索引最左列后的计划:
EXPLAIN FORMAT=TRADITIONAL
SELECT id, created_at
FROM orders
WHERE state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
普通计划:
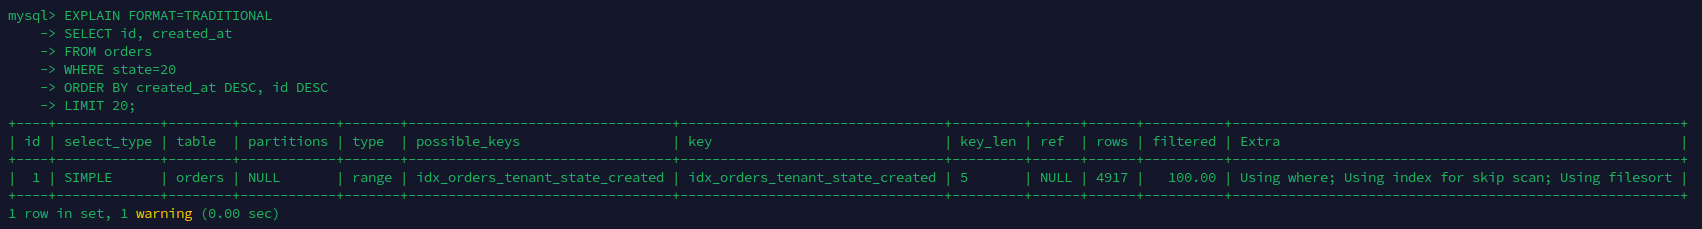
state 位于索引第二列,不能像上一组一样构造单个连续范围。本次优化器选择 Using index for skip scan:执行器在索引中枚举不同的 tenant_id,分别构造并扫描 (tenant_id=t,state=20) 子范围,而不是把原 SQL 改写成一串 tenant_id 条件。
这些子范围各自在租户内部按时间排列,但整个索引先按 tenant_id 分组,不能直接提供跨租户的全局时间顺序,所以计划出现 Using filesort。即使排序阶段可能因 LIMIT 20 使用 Top-N 优先队列,也仍需检查各子范围产生的候选记录;传统计划中的 rows=4917 仍是估算值,实际输入量需要查看排序节点的子节点:
EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
实际计划:
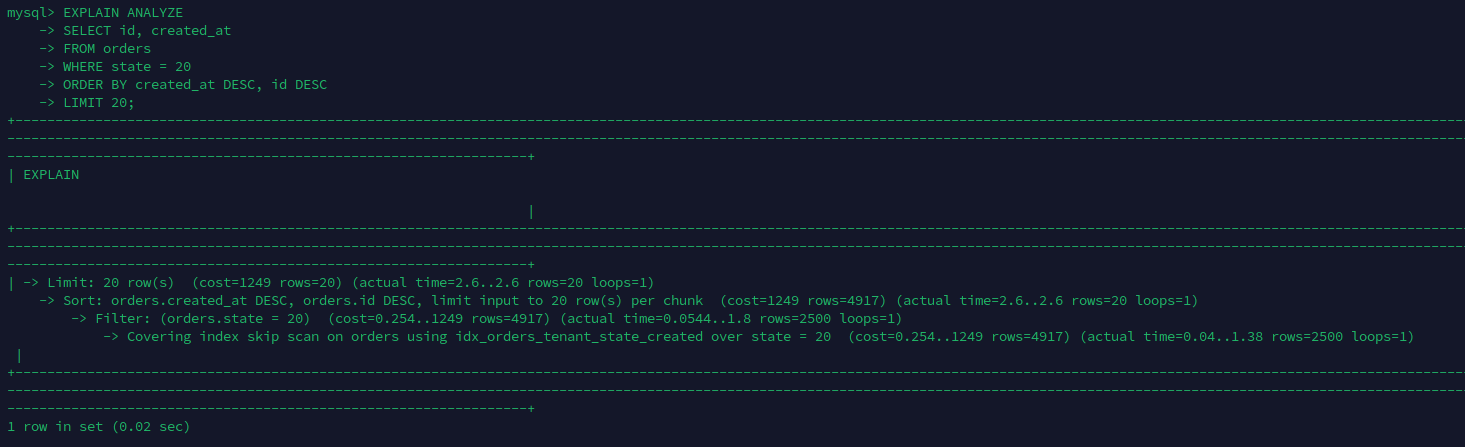
最下层的 Covering index skip scan 估算产生 4917 行,实际产生 2500 行,恰好等于公共数据中全部 state=20 的订单数。其上的 Filter 仍检查 state=20,但输入和输出都是 2500 行,说明实际没有再过滤掉记录;本次估算约为实际值的 1.97 倍。
Sort 节点显示 limit input to 20 row(s) per chunk,说明排序过程感知 LIMIT 20,最终只向上层产生 20 行。然而它的子节点已经输出了 2500 行,所以这里的 LIMIT 只减少排序保留量和最终输出量,没有把 Skip Scan 的读取量降到 5 × 20 = 100 行。与 6.1 相比,决定差异的不是是否覆盖——本组同样是覆盖访问——而是缺少固定的 tenant_id 后,索引不能直接提供跨租户的全局时间顺序,必须先消费所有候选再排序。
6.3 等值前缀与时间范围
本组不加 LIMIT,以便完整观察时间范围。基线中的精确匹配数为 21:
SELECT COUNT(*) AS matched_rows
FROM orders
WHERE tenant_id = 2 AND state = 20
  AND created_at >= '2024-02-01'
  AND created_at < '2024-03-01';
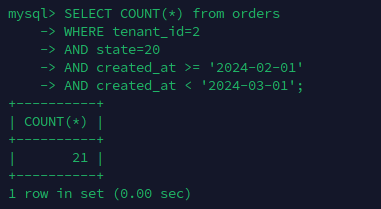
再查看优化器如何使用联合索引:
EXPLAIN FORMAT=TRADITIONAL
SELECT id, created_at
FROM orders
WHERE tenant_id = 2 AND state = 20
  AND created_at >= '2024-02-01'
  AND created_at < '2024-03-01'
ORDER BY created_at DESC, id DESC;
普通计划:
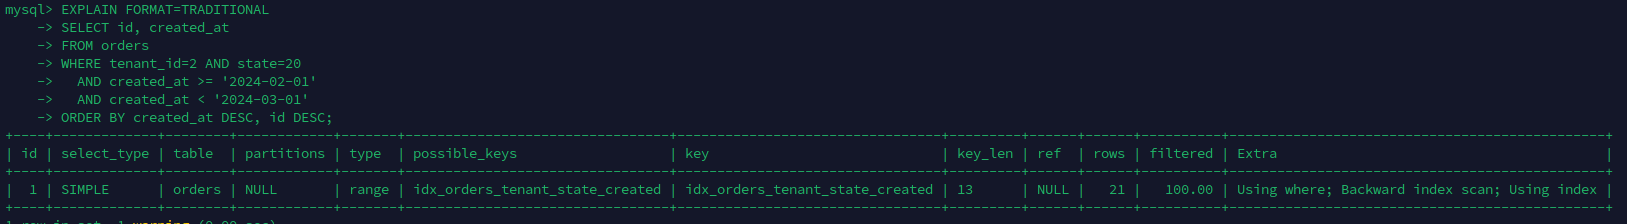
固定 tenant_id,state 后,created_at 的上下界继续缩小索引范围。由于结果要求倒序,执行器可以从小于 2024-03-01 的范围高端开始反向读取,直到低于 2024-02-01,无需先从下界正向读取再反转。计划中的 rows=21 仍是估算;Using index 和没有 Using filesort 分别表示覆盖访问和无需额外排序。
EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE tenant_id = 2 AND state = 20
  AND created_at >= '2024-02-01'
  AND created_at < '2024-03-01'
ORDER BY created_at DESC, id DESC;
实际计划:
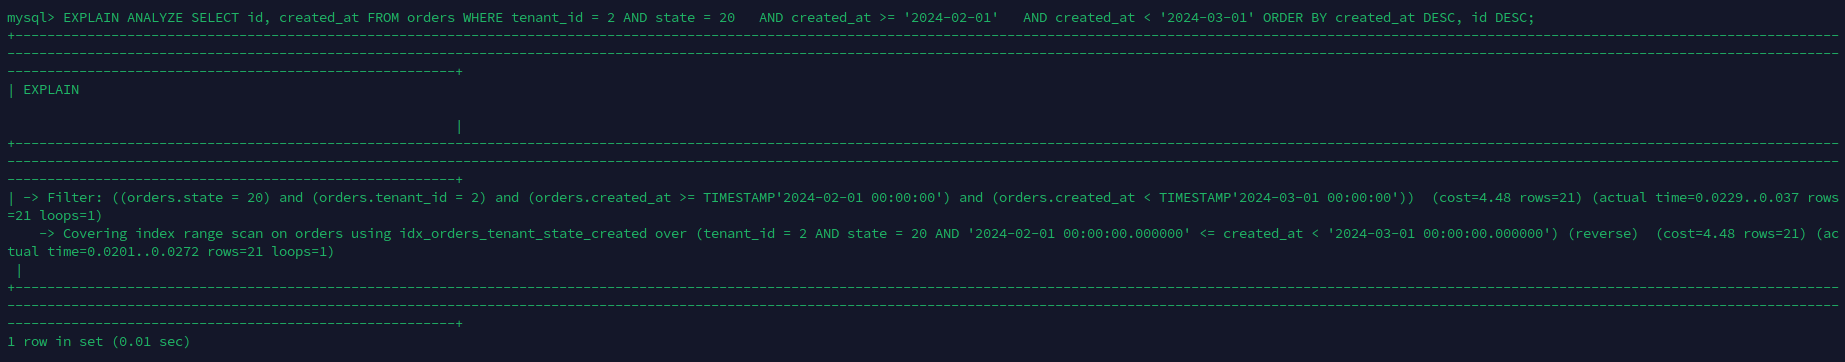
Covering index range scan ... (reverse) 将 tenant_id=2、state=20 和两个时间边界都纳入索引范围,估算与实际输出均为 21 行,loops=1。上层 Filter 复核完整条件后仍输出 21 行,没有额外淘汰记录。
计划中没有 Sort 节点,说明从时间范围高端向低端反向扫描已经满足 created_at DESC,id DESC;Covering 则说明 id,created_at 可以直接从二级索引返回。这组结果同时验证了等值前缀、时间范围、倒序读取和覆盖访问能够在同一索引路径中配合使用。
6.4 非覆盖投影与回表
最后恢复第一组的过滤和排序条件,只把返回列从索引中的 created_at 换成索引外的 total_amount:
EXPLAIN FORMAT=TRADITIONAL
SELECT id, total_amount
FROM orders
WHERE tenant_id = 2 AND state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
普通计划:
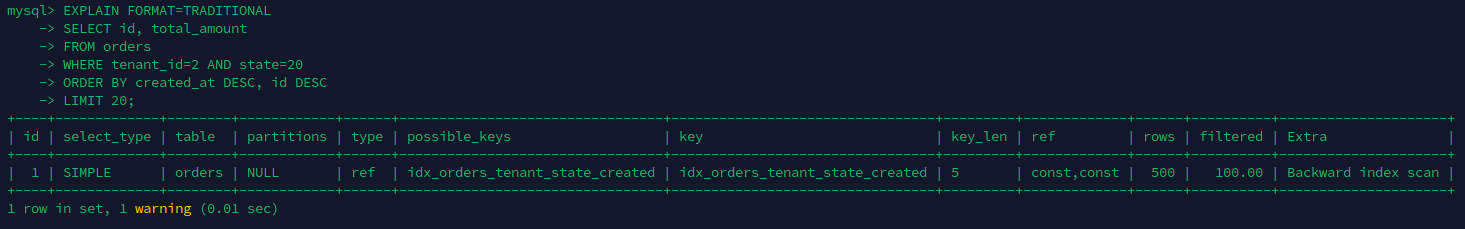
这一组与 6.1 的条件相同,不是 6.3 的 21 行时间范围。tenant_id,state 仍定位约 500 行的候选范围,created_at,id 仍提供所需顺序,LIMIT 20 仍可能使读取提前停止;变化仅在于 total_amount 不在该二级索引中,因此每个返回候选都需要根据主键访问聚簇记录。普通计划不再显示 Using index,但仍显示 Backward index scan,说明回表与是否需要额外排序是两个不同问题。
EXPLAIN ANALYZE
SELECT id, total_amount
FROM orders
WHERE tenant_id = 2 AND state = 20
ORDER BY created_at DESC, id DESC
LIMIT 20;
实际计划:
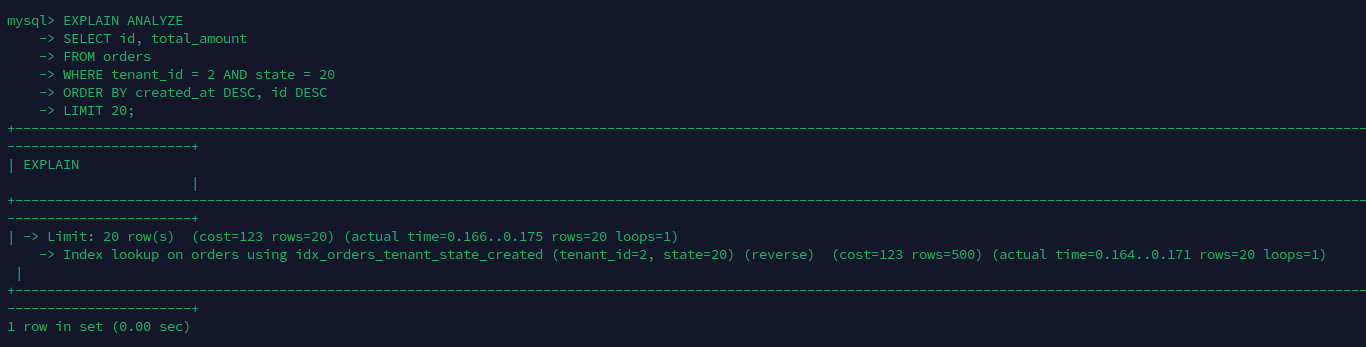
最外层 Limit 实际输出 20 行,下层 Index lookup ... (reverse) 也只产生 20 行,而不是普通计划估算的 500 行,说明有序读取仍然可以在获得 20 条结果后提前停止。计划中没有 Sort,因此读取 total_amount 并未破坏联合索引提供的顺序。
与 6.1 的关键区别是节点名称不再包含 Covering。执行器先从 idx_orders_tenant_state_created 找到索引记录,再根据其中的主键取得 total_amount,所以这是非覆盖访问。TREE 将这条路径显示为一个 Index lookup 节点,其 actual rows=20 是向上层返回的行数,不能把 20 条二级索引记录和相应的聚簇索引访问相加后写成“扫描 40 行”。本次耗时高于 6.1 也符合回表增加工作的方向,但单次执行容易受缓存和机器状态影响,不能据此量化回表成本。
四组实际计划的关键证据可以归纳如下:
| 场景 | 访问节点估算行数 | 访问节点实际行数 | 最终输出 | 排序 | 访问方式 |
|---|---|---|---|---|---|
等值前缀 + LIMIT |
500 | 20 | 20 | 无 | 覆盖索引逆序查找 |
缺少 tenant_id |
4917 | 2500 | 20 | 限量 Sort |
覆盖索引 Skip Scan |
| 等值前缀 + 时间范围 | 21 | 21 | 21 | 无 | 覆盖索引逆序范围扫描 |
| 等值前缀 + 非覆盖列 | 500 | 20 | 20 | 无 | 非覆盖索引逆序查找并访问聚簇记录 |
表中的“访问节点实际行数”表示该节点向父节点产生的行数,不等同于存储引擎内部访问过的所有索引记录或页。尤其是第二组,判断排序前的工作量要看 Sort 的子节点输出 2500 行,而不能只看最外层 Limit 的 20 行。
本节只用 EXPLAIN ANALYZE 核对这些与索引设计直接相关的证据,不比较容易受缓存和机器状态影响的单次耗时;迭代器时间、循环次数和估算偏差将在下一篇继续展开。
七、EX-M02-03:辨认表达式与前置通配符的访问路径
“索引失效”把多种结果混在一起:有时是无法构造范围,有时是优化器估算全表扫描更便宜,有时仍扫描索引却不能高效定位。本实验继续使用公共 orders 和已有索引,每组只改变一种条件写法。
7.1 主键列与表达式
EXPLAIN ANALYZE
SELECT *
FROM orders
WHERE id + 0 = 1234;

EXPLAIN ANALYZE
SELECT *
FROM orders
WHERE id = 1234;
对照两个计划的访问路径和实际扫描行数,判断优化器能否从条件直接构造主键查找。两组均应返回 id=1234 的同一笔订单,但返回行数相同不代表读取工作量相同。
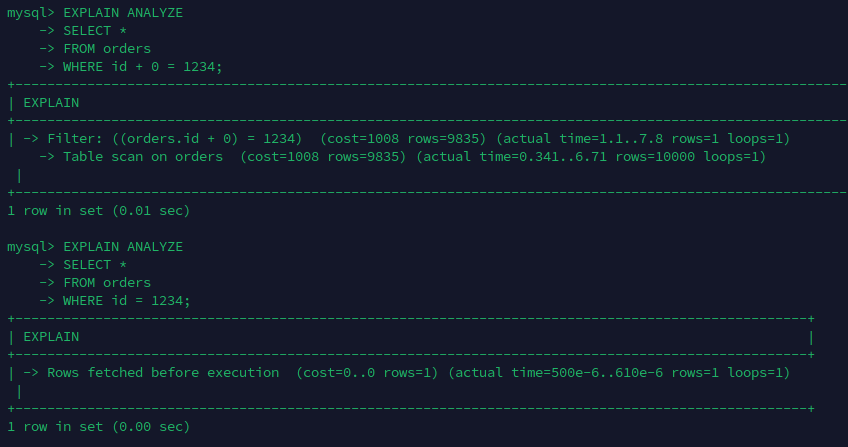
在索引进行表达式计算会使索引失效,走全表扫描,等值匹配走索引优化。
7.2 日期函数与半开区间
这组查询都固定 tenant_id,state,使已有联合索引的前两列成为等值前缀,再比较第三列 created_at 的两种写法。这样可以观察函数对时间范围定位的影响,无需另外创建单列时间索引:
EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE tenant_id=2 AND state=20
  AND DATE(created_at) = '2024-02-01';

EXPLAIN ANALYZE
SELECT id, created_at
FROM orders
WHERE tenant_id=2 AND state=20
  AND created_at >= '2024-02-01'
  AND created_at < '2024-02-02';
两组都应返回同一批 7 笔订单。DATE(created_at) 对原列求值,普通 B+Tree 保存的却是原始 created_at 顺序,因而通常无法直接根据函数结果构造时间范围起点。即使如此,前面的租户和状态条件仍可能利用索引缩小候选范围,不能把整条查询称为“索引完全失效”。
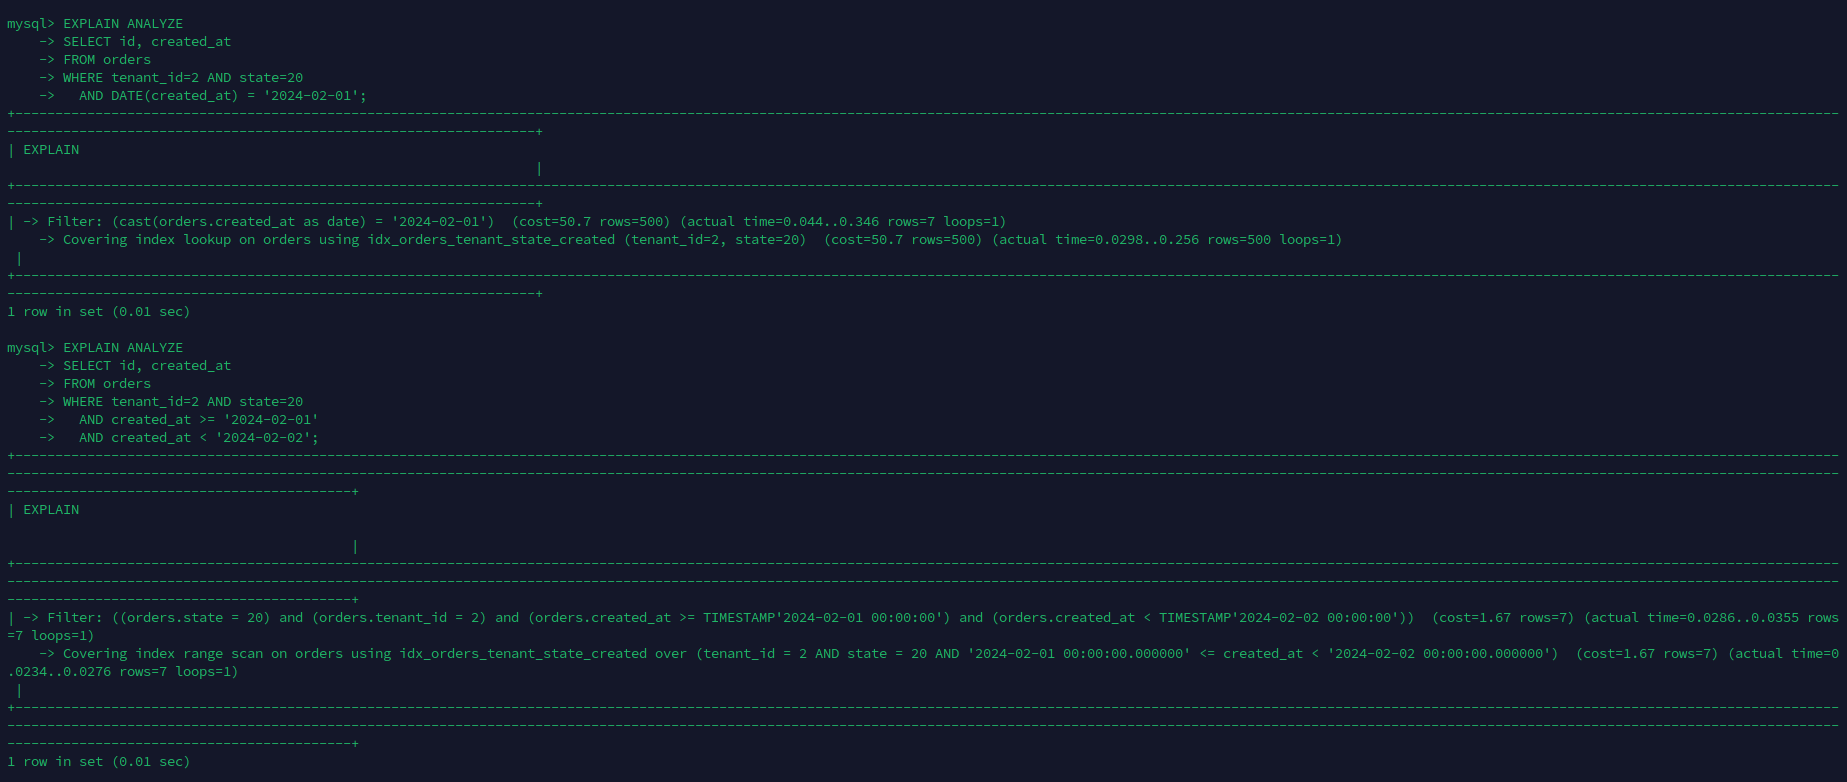
[day,day+1) 半开区间既保留原列形式,也避开 23:59:59.999999 一类精度边界。记录两个计划的定位条件、过滤位置、扫描行数和实际返回行数,判断是否从租户状态组内的过滤变为更小的时间范围扫描。
7.3 前置通配符与确定前缀
order_no 有独立唯一索引。第一篇按用户 id=123 派生的订单号是 ORD00000000000000000123,以下两种写法在当前基线中都匹配这一笔订单。订单自身的 id 由自增分配,不应假定它与用户 ID 相同:
EXPLAIN ANALYZE
SELECT id, order_no
FROM orders
WHERE order_no LIKE '%0000000123';

EXPLAIN ANALYZE
SELECT id, order_no
FROM orders
WHERE order_no LIKE 'ORD00000000000000000123%';
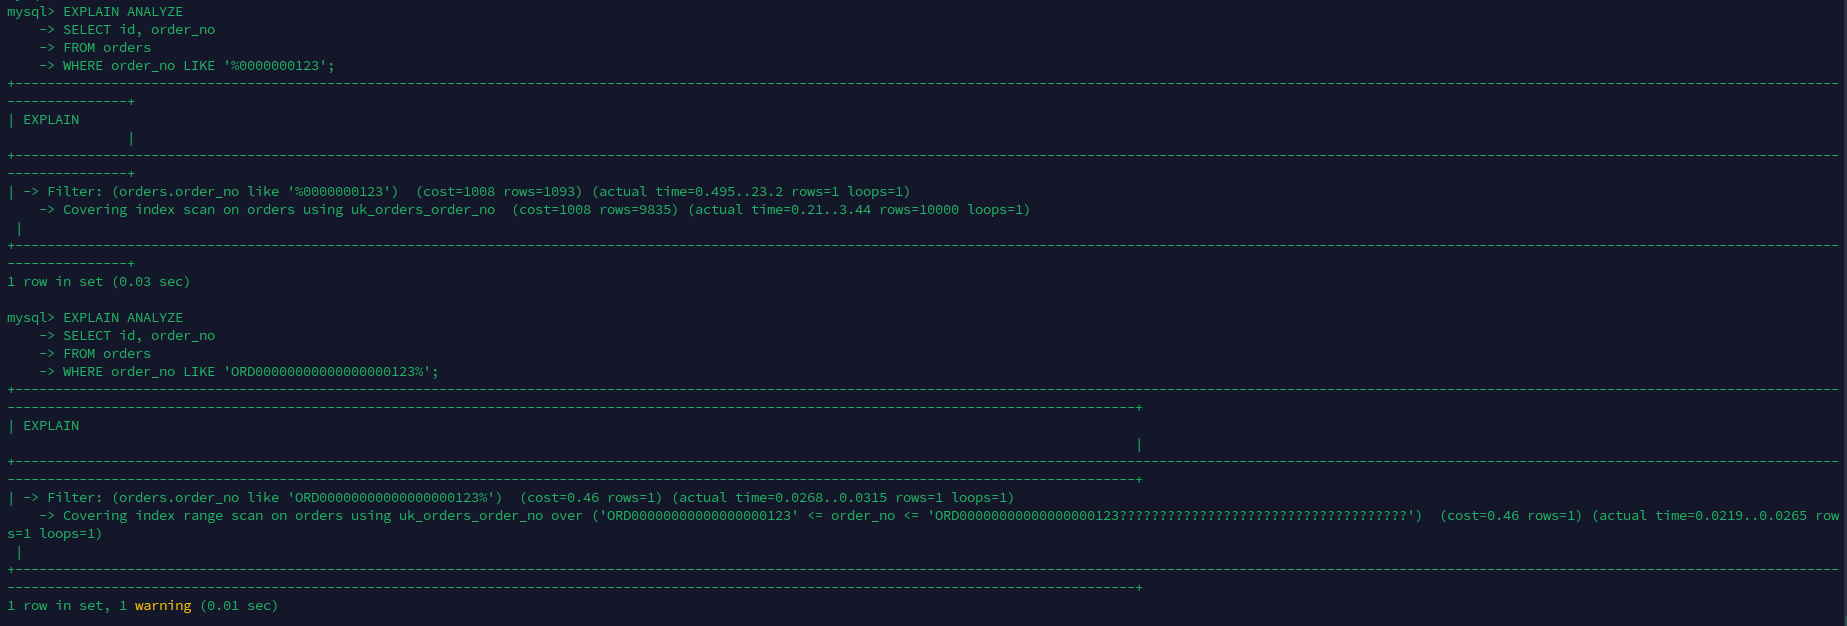
前置通配符没有确定的左侧前缀,普通字符串 B+Tree 难以直接定位范围起点;确定前缀则可能转化为索引范围。两种模式在其他数据集上不一定返回相同集合,本例相同是固定订单号规则和数据范围的结果。
若后缀查询是真实需求,应考虑保存并索引规范化后的可查询部分,而不是默认对完整字符串做前导通配扫描。函数索引也是选项,但会把表达式定义和写入维护成本固化到 schema 中。
到这里,三个基础实验都围绕第一篇已有的表、数据和索引完成。保存计划后,可以继续对照主键的写入行为。
八、EX-M02-04:用扩展订单源对照三类主键
前面的读路径实验继续复用第一篇建立的公共 orders 表(10,000 行)。本节只研究主键宽度和顺序性对写入、聚簇索引和二级索引空间的综合影响,使用 1,000,000 行压力规模。
1,000,000 行用于放大页分裂、缓存占用和二级索引放大的差异。即使在该规模下差异仍不明显,也只能说明当前硬件、缓冲池和负载对该差异不敏感,不能推导三种主键在所有生产场景中性能等价。
三种主键需要不同的列定义,因此仍使用 CREATE TABLE ... LIKE orders 派生目标表。订单号、租户、用户、状态、金额和时间来自同一份扩展源数据,二级索引定义保持一致;目标表只用于测量,不作为公共订单项或支付记录的关联目标。
8.1 准备扩展数据
扩展源数据由公共 orders 按批次复制得到。每个副本生成新的 seq_id 和 order_no,其余业务字段沿用公共订单的分布。这样可以扩大数据量,又不会因为重复唯一键而失败。该数据是可复现的基准数据,不模拟生产中的长尾用户、热门 SKU 或并发流量。
先确认扩展实验对象不存在;如果查询返回已有表名,应先核实来源和数据,不能直接删除后重跑:
USE mysql_lab;
SET SESSION cte_max_recursion_depth = 20000;

SET @base_rows = 10000;
SET @scale_rows = 1000000;
SET @copies = @scale_rows DIV @base_rows;

SELECT @base_rows AS base_rows,
       @scale_rows AS scale_rows,
       @copies AS copies,
       @scale_rows = 1000000 AS scale_valid,
       MOD(@scale_rows,@base_rows) AS remainder;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN (
    'pk_scale_source',
    'pk_auto_scale_lab',
    'pk_global_scale_lab',
    'pk_random_scale_lab'
  );
scale_valid 应为 1,remainder 应为 0,copies 应为 100。确认公共 orders 仍有 10,000 行后,创建不带二级索引的扩展源表:
CREATE TABLE pk_scale_source (
  seq_id BIGINT UNSIGNED NOT NULL,
  order_no VARCHAR(32) NOT NULL,
  tenant_id INT UNSIGNED NOT NULL,
  user_id BIGINT UNSIGNED NOT NULL,
  state TINYINT UNSIGNED NOT NULL,
  total_amount DECIMAL(12,2) NOT NULL,
  created_at DATETIME(6) NOT NULL,
  updated_at DATETIME(6) NOT NULL,
  PRIMARY KEY (seq_id)
) ENGINE=InnoDB;
使用递归 CTE 生成批次。源表的写入不计入三种主键的耗时:
INSERT INTO pk_scale_source
  (seq_id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
WITH RECURSIVE batches AS (
  SELECT 0 AS batch_no
  UNION ALL
  SELECT batch_no + 1
  FROM batches
  WHERE batch_no + 1 < @copies
)
SELECT o.id + b.batch_no * @base_rows AS seq_id,
       CONCAT('ORD',LPAD(o.id + b.batch_no * @base_rows,20,'0')) AS order_no,
       o.tenant_id,o.user_id,o.state,o.total_amount,o.created_at,o.updated_at
FROM batches AS b
CROSS JOIN orders AS o
ORDER BY seq_id;
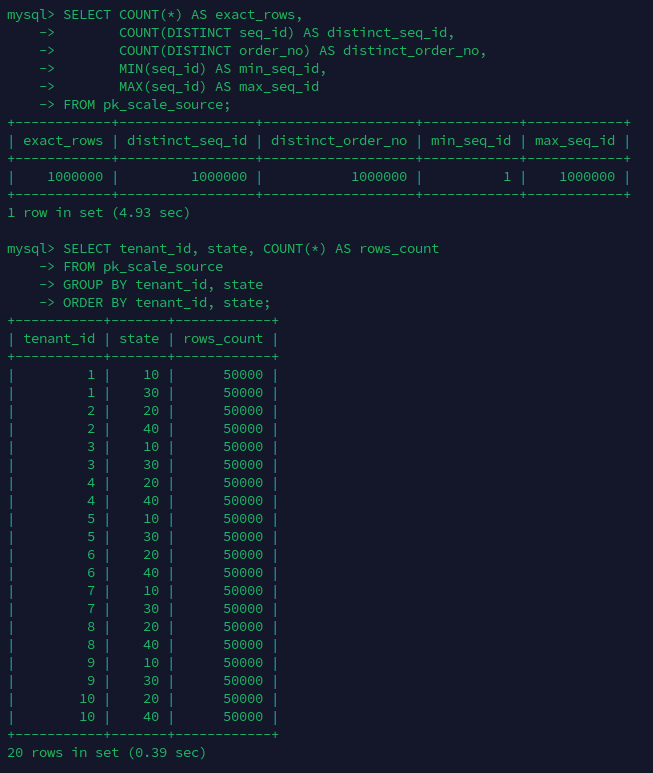
生成完成后核验行数、唯一性和分布。1,000,000 行时每个状态应有 250,000 行、每个租户应有 100,000 行:
SELECT COUNT(*) AS exact_rows,
       COUNT(DISTINCT seq_id) AS distinct_seq_id,
       COUNT(DISTINCT order_no) AS distinct_order_no,
       MIN(seq_id) AS min_seq_id,
       MAX(seq_id) AS max_seq_id
FROM pk_scale_source;

SELECT tenant_id, state, COUNT(*) AS rows_count
FROM pk_scale_source
GROUP BY tenant_id, state
ORDER BY tenant_id, state;
8.2 创建三种主键目标表
目标表使用不同名称,避免与基础实验混淆:
CREATE TABLE pk_auto_scale_lab LIKE orders;
CREATE TABLE pk_global_scale_lab LIKE orders;
CREATE TABLE pk_random_scale_lab LIKE orders;

-- 保留其余列、索引和 CHECK 约束,只调整主键属性。
ALTER TABLE pk_auto_scale_lab AUTO_INCREMENT = 1;
ALTER TABLE pk_global_scale_lab MODIFY COLUMN id BIGINT UNSIGNED NOT NULL;
ALTER TABLE pk_random_scale_lab MODIFY COLUMN id BINARY(16) NOT NULL;

SHOW CREATE TABLE pk_auto_scale_lab;
SHOW CREATE TABLE pk_global_scale_lab;
SHOW CREATE TABLE pk_random_scale_lab;
LIKE 会复制列属性、索引和 CHECK 约束,其中检查约束的名称会重新生成。应确认三张表除主键类型、自增属性和自动生成的约束名外,业务字段及二级索引列定义一致。
8.3 三轮平衡写入
该规模执行三轮,继续使用当前的平衡顺序,而不是固定让某一种主键总是第一个或最后一个:
| 轮次 | 执行顺序 |
|---|---|
| 1 | auto → global → random |
| 2 | global → random → auto |
| 3 | random → auto → global |
该顺序使每种主键各处于第一、第二、第三位置一次,足以抵消一部分缓存、日志刷盘和后台任务造成的位置偏差,不需要执行全部 6 种排列。若同一种主键三轮耗时波动超过约 10%,再增加到 5 轮。
每轮开始时清空三张目标表。清理和统计不计入插入耗时:
TRUNCATE TABLE pk_auto_scale_lab;
TRUNCATE TABLE pk_global_scale_lab;
TRUNCATE TABLE pk_random_scale_lab;
三条写入都按 seq_id 读取同一份源数据。pk_global_scale_lab 只模拟严格递增的 64 位编码,不能验证真实 ID 服务的时钟回拨、节点冲突或并发生成能力;pk_random_scale_lab 的耗时包含 RANDOM_BYTES(16) 生成成本,并同时改变了主键宽度和顺序性:
SET @t0 = NOW(6);
INSERT INTO pk_auto_scale_lab
  (order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
SELECT order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
FROM pk_scale_source
ORDER BY seq_id;
SET @t1 = NOW(6);
SELECT 'pk_auto_scale_lab' AS table_name,
       TIMESTAMPDIFF(MICROSECOND,@t0,@t1) / 1000000 AS elapsed_seconds;

SET @t0 = NOW(6);
INSERT INTO pk_global_scale_lab
  (id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
SELECT 7000000000000000000 + seq_id,
       order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
FROM pk_scale_source
ORDER BY seq_id;
SET @t1 = NOW(6);
SELECT 'pk_global_scale_lab' AS table_name,
       TIMESTAMPDIFF(MICROSECOND,@t0,@t1) / 1000000 AS elapsed_seconds;

SET @t0 = NOW(6);
INSERT INTO pk_random_scale_lab
  (id,order_no,tenant_id,user_id,state,total_amount,created_at,updated_at)
SELECT RANDOM_BYTES(16),
       order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
FROM pk_scale_source
ORDER BY seq_id;
SET @t1 = NOW(6);
SELECT 'pk_random_scale_lab' AS table_name,
       TIMESTAMPDIFF(MICROSECOND,@t0,@t1) / 1000000 AS elapsed_seconds;
三轮使用同一个连接、相同的事务模式和相同的执行环境。只记录 INSERT ... SELECT 本身;不要把 TRUNCATE、ANALYZE TABLE、统计查询和结果整理时间计入。若同一台机器还有其他负载,应记录并尽量保持各轮一致。
8.4 记录与汇总实验结果
本实验固定使用 1,000,000 行,耗时和空间明细统一按“轮次 + 主键方案”记录。每条插入完成后记录耗时;同一轮三张表都写入完成后,再核验精确行数、更新统计信息并查询空间。这样可以直接把一个主键方案的写入耗时与空间结果对应起来。
每轮三张表都写入完成后,先核验精确行数,再更新统计信息并查询空间:
SELECT 'pk_auto_scale_lab' AS table_name, COUNT(*) AS exact_rows
FROM pk_auto_scale_lab
UNION ALL
SELECT 'pk_global_scale_lab', COUNT(*) FROM pk_global_scale_lab
UNION ALL
SELECT 'pk_random_scale_lab', COUNT(*) FROM pk_random_scale_lab;

ANALYZE TABLE
  pk_auto_scale_lab,
  pk_global_scale_lab,
  pk_random_scale_lab;

SELECT TABLE_NAME,
       TABLE_ROWS,
       DATA_LENGTH,
       INDEX_LENGTH,
       DATA_LENGTH + INDEX_LENGTH AS TOTAL_LENGTH,
       DATA_FREE
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN (
    'pk_auto_scale_lab',
    'pk_global_scale_lab',
    'pk_random_scale_lab'
  )
ORDER BY TABLE_NAME;
空间统计与耗时合并为一张明细表。exact_rows 来自 COUNT(*),TABLE_ROWS 是 InnoDB 的统计估算值,TOTAL_LENGTH 等于 DATA_LENGTH + INDEX_LENGTH,每行总空间使用 TOTAL_LENGTH / exact_rows 计算,DATA_FREE 单独记录,不并入总空间:
| 轮次 | 执行顺序 | 方案 | 耗时(s) | 精确行数 | TABLE_ROWS |
DATA_LENGTH(字节) |
INDEX_LENGTH(字节) |
总空间(字节) | 每行总空间(字节) | DATA_FREE(字节) |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | auto → global → random | pk_auto_scale_lab |
16.2665 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 1 | auto → global → random | pk_global_scale_lab |
16.4475 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 1 | auto → global → random | pk_random_scale_lab |
84.9270 | 1000000 | 953288 | 163332096 | 178339840 | 341671936 | 342 | 4194304 |
| 2 | global → random → auto | pk_auto_scale_lab |
17.1199 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 2 | global → random → auto | pk_global_scale_lab |
16.5891 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 2 | global → random → auto | pk_random_scale_lab |
85.9368 | 1000000 | 917147 | 163332096 | 178339840 | 341671936 | 342 | 4194304 |
| 3 | random → auto → global | pk_auto_scale_lab |
16.6093 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 3 | random → auto → global | pk_global_scale_lab |
16.8147 | 1000000 | 994563 | 92930048 | 124682240 | 217612288 | 218 | 7340032 |
| 3 | random → auto → global | pk_random_scale_lab |
84.8287 | 1000000 | 1008521 | 163332096 | 178339840 | 341671936 | 342 | 4194304 |
三轮完成后汇总耗时和空间结果:
| 方案 | 轮数 | 中位数耗时(s) | 最小~最大(s) | 平均总空间(字节) | 平均每行空间(字节) |
|---|---|---|---|---|---|
pk_auto_scale_lab |
3 | 16.6093 | 16.2665~17.1199 | 217612288 | 218 |
pk_global_scale_lab |
3 | 16.5891 | 16.4475~16.8147 | 217612288 | 218 |
pk_random_scale_lab |
3 | 84.9270 | 84.8287~85.9368 | 341671936 | 342 |
TABLE_ROWS、DATA_LENGTH 和 INDEX_LENGTH 采用 InnoDB 的统计口径,不能代替精确计数或逐字节文件检查。应优先比较同一轮中三种主键的相对结果;DATA_FREE 还可能受到表空间复用影响,不作为主键空间结论的核心指标。即使使用 1,000,000 行,Buffer Pool 仍可能缓存部分工作集,因此多轮执行和位置平衡仍然必要。
结果分析
三轮结果把三种方案分成了两组:两个有序的 8 字节 BIGINT 主键表现接近,随机的 16 字节 BINARY 主键则在耗时和空间上都出现了稳定差异。
pk_auto_scale_lab的中位耗时为 16.6093 秒,pk_global_scale_lab为 16.5891 秒,相差约 0.12%;两者的耗时区间也明显重叠。它们的DATA_LENGTH、INDEX_LENGTH和总空间完全相同,说明在这组单连接批量写入中,没有观察到自增BIGINT与严格递增的全局BIGINT之间存在可辨识的数据库侧差异。这里没有测量真实 ID 服务的网络调用、时钟和并发生成成本,因此结论只针对 ID 写入 InnoDB 之后的行为。pk_random_scale_lab的中位耗时为 84.9270 秒,约为自增组的 5.11 倍;三轮结果稳定在 84.8287~85.9368 秒,而且分别处于第一、第二、第三执行位置,说明差异不是某一个固定执行位置造成的。不过,这个倍数同时包含RANDOM_BYTES(16)的生成成本、主键从 8 字节增至 16 字节、随机位置写入聚簇索引以及二级索引维护成本,不能全部归因于页分裂。- 随机主键表的总空间为 341,671,936 字节,有序
BIGINT表为 217,612,288 字节,增加约 57.0%,即每行由约 218 字节增至 342 字节。进一步拆分后,DATA_LENGTH增加约 75.8%,INDEX_LENGTH增加约 43.0%,符合更宽主键和较差页利用率会同时放大聚簇索引与二级索引的预期。 - 三张表的精确行数均为 1,000,000,但随机主键表的
TABLE_ROWS在 917,147~1,008,521 之间变化。这是统计估算误差,不表示插入丢失;完整性判断应以COUNT(*)和下一节的业务字段核验为准。DATA_FREE较小也不代表随机主键空间利用率更高,它不应脱离表空间分配和复用状态单独比较。
因此,本实验能够支持的结论是:在当前单连接、一次性批量写入、相同业务字段和二级索引的条件下,紧凑且有序的 8 字节主键比随机 16 字节主键具有更好的写入耗时和空间表现;自增 BIGINT 与严格递增的全局 BIGINT 没有可辨识的数据库侧差异。它不能进一步证明自增主键在高并发写入、分片或真实分布式 ID 服务场景中始终最优,这些场景还需要针对并发竞争、ID 生成链路和实际流量分布单独压测。
8.5 业务字段与主键结果核验
扩展源表中的 order_no 已重新生成,不能再直接与公共 orders 按订单号连接;应与 pk_scale_source 对照,确认三种主键只改变主键值,业务字段完全一致:
SELECT p.source_table, COUNT(*) AS mismatched_rows
FROM (
  SELECT 'pk_auto_scale_lab' AS source_table,
         order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
  FROM pk_auto_scale_lab
  UNION ALL
  SELECT 'pk_global_scale_lab',
         order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
  FROM pk_global_scale_lab
  UNION ALL
  SELECT 'pk_random_scale_lab',
         order_no,tenant_id,user_id,state,total_amount,created_at,updated_at
  FROM pk_random_scale_lab
) AS p
LEFT JOIN pk_scale_source AS s ON s.order_no = p.order_no
WHERE s.seq_id IS NULL
   OR p.tenant_id <> s.tenant_id OR p.user_id <> s.user_id
   OR p.state <> s.state OR p.total_amount <> s.total_amount
   OR p.created_at <> s.created_at OR p.updated_at <> s.updated_at
GROUP BY p.source_table;

SELECT 'pk_random_scale_lab' AS table_name,
       COUNT(*) AS exact_rows,
       COUNT(DISTINCT id) AS distinct_ids
FROM pk_random_scale_lab;
第一条查询应返回零行,随机主键的 exact_rows 和 distinct_ids 应相等。三张目标表的精确行数都必须等于 @scale_rows。
8.6 清理扩展实验
记录完三轮结果后,只删除本节创建的扩展对象,不触碰第一篇的公共表:
DROP TABLE
  pk_auto_scale_lab,
  pk_global_scale_lab,
  pk_random_scale_lab,
  pk_scale_source;

SELECT
  (SELECT COUNT(*) FROM users) AS users_count,
  (SELECT COUNT(*) FROM orders) AS orders_count,
  (SELECT COUNT(*) FROM order_items) AS items_count,
  (SELECT COUNT(*) FROM payments) AS payments_count;

SHOW INDEX FROM orders;

SELECT TABLE_NAME
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mysql_lab'
  AND TABLE_NAME IN (
    'pk_scale_source',
    'pk_auto_scale_lab',
    'pk_global_scale_lab',
    'pk_random_scale_lab'
  );
验收时确认四张公共表仍各有 10,000 行,orders 的索引定义与 EX-M02-01 一致,扩展源表和三张扩展目标表均已不存在。最终结论应以 1,000,000 行实验的多轮中位数为依据,而不是根据单轮客户端耗时下结论。
九、索引选择的工程检查表
添加索引前回答:
- 它服务哪条高价值查询?
- 等值、范围、排序和投影列分别是什么?
- 数据选择性和返回比例如何?
- 是否已有可复用的索引前缀?
- 是否值得为覆盖增加写放大和空间?
- 执行计划和实际行数如何证明收益?
- 哪些写路径、DDL 和缓存会受影响?
这份检查表的核心是把索引从“列的属性”改成“查询与写入的共同设计”。一个索引可能同时改善查询、扩大表空间、降低写吞吐、延长 DDL 和改变锁扫描范围。评审时应记录它服务的 SQL digest 和删除条件,否则无用索引很难被安全清理。
十、迁移任务:分布式订单号
未来扩展到 64 个分片时,订单 ID 既要全局唯一,又要支持订单号点查与用户订单列表。一个完整设计需要明确:
- 技术主键的生成方式;
- 业务订单号是否携带路由信息;
- 用户维度索引;
- 随机 UUID 字符串作为主键的替代方案;
- ID 生成器故障和时钟回拨边界。
可采用 64 位全局 ID 作为聚簇主键,在位分配中保留时间、节点和序列号,但不应让业务直接解析每一位;布局一旦成为外部协议就难以调整。order_no 可独立生成,并携带稳定的路由片段或通过全局路由表映射到分片。用户订单列表仍以 user_id 为路由键,在分片内保留 (user_id,created_at,id)。
如果 ID 生成器依赖时钟,必须定义回拨时的拒绝、等待或备用时钟策略,并防止节点号重复。随机 UUID 字符串同时带来宽主键、字符比较和写入局部性问题;如果确实需要 UUID,应优先用 BINARY(16) 表示并经过同条件实验,而不是默认使用 CHAR(36) 主键。
十一、阶段性结论
- DOCUMENTED:InnoDB 把行组织在聚簇索引中,二级索引记录携带主键值。这使主键的宽度和稳定性成为整表设计,而不是一条约束的局部选择。
- INFERRED:联合索引应从等值、范围、排序、投影和
LIMIT的组合推导,覆盖收益要与写放大和空间成本一起评估。
设计索引的可验收表达不是“这个列很常用”,而是“这条 SQL 在这个数据分布下,应将候选扫描从 X 降到 Y,并用一次有限回表换取更低的写成本”。下一篇将继续围绕租户 2 的已支付订单,进一步拆解 EXPLAIN ANALYZE 的迭代器、估算偏差与优化器选择。